Cookie与登录态 · 讲义与学习笔记
搞懂浏览器如何靠Cookie记住你登录的——能向别人通俗讲清整套流程。
整理:问学·科技
第 1 关 · HTTP 无状态:为什么我们需要「小纸条」
理解 HTTP 协议天生「失忆」这一根本事实,以及登录态问题为何必须靠额外机制解决。
HTTP 请求天然无状态
想象你走进一家商店,每次经过柜台,店员都像第一次见到你一样——哪怕你五分钟前才在这家店刷过会员卡。这种「每次都当陌生人」的设定,就是 HTTP 协议最核心的特征之一:**无状态**。
什么是 HTTP?
HTTP(HyperText Transfer Protocol,超文本传输协议)是浏览器和服务器之间「说话的方式」。当你在地址栏输入网址、点击链接、或者提交一个表单,浏览器其实就是在用 HTTP 协议向服务器「喊话」:把那个网页给我、把那个数据给我。服务器听完,扔回一个回应,结束。
什么是「无状态」?
「无状态」(stateless)的意思是:**每一次请求都是独立的、互不相关的**。
服务器处理完你这一次的请求之后,**不会主动记住你是谁、你刚才做了什么**。下一次你再来,它照样把你当新客人。
举个具体的例子:
- 你先访问 `https://example.com/login`,填好用户名密码,登录成功——服务器返回「登录成功」的页面。
- 接着你点了一下页面上的链接,跳到 `https://example.com/home`。
- 你的浏览器向服务器发出新的 HTTP 请求:「把首页给我。」
- 服务器收到请求,开始处理。它**完全不记得**你刚刚登录过。在它眼里,这就是一次全新的、与之前毫无关系的访问。
flowchart LR
    A[浏览器 请求 login 页面] --> B[服务器 验证密码 返回成功]
    B -. 用户点击链接 .-> C[浏览器 请求 home 页面]
    C --> D[服务器 当作新访客处理]
注意看:服务器在第二次请求时,并没有把第一次的「你已登录」这件事记在心里。虚线表示这是用户的行为(点链接),但服务器自己**没有任何记忆**把这个动作和上一次的请求连起来。
为什么 HTTP 要设计成「失忆」?
这并不是 bug,而是**有意为之**。最初设计 HTTP 的时候,互联网还只是用来传传文档、看看论文。每次请求都是一次「取个东西走人」的简单动作,服务器不需要为了「记得你是谁」而保存任何东西。
这样做的好处是:
- **服务器更简单**:不需要维护「每个用户上次聊到哪儿了」的状态表。
- **能同时服务更多人**:不用一边响应一边翻小本本查你是谁。
- **更稳定**:服务器即使重启、或者换成另一台,也不会因为「忘了你」而出问题。
代价也很明显:**服务器自己永远不会主动记得你**。你登录了、你买了东西、你看过的页面——服务器下一秒统统忘光。
一个生活类比
把 HTTP 想成一家只有「失忆店员」的便利店:
- 你进店买一瓶水,付完钱走了。
- 五分钟后你又进店想退换——店员完全不认识你,也不知道你刚才买过什么。
- 每次进店,店员都从「您好请问需要什么」开始。
互联网早期的网站,就像这样一家店——反正你只是来看一篇文章、看一张图片,记不记得你不重要。但当网站开始需要「登录」这件事的时候,问题就来了:**我登录了之后,怎么让下一个页面也知道我登录过?**
这就是下一节要聊的「登录态问题」。
**要点:**HTTP 是浏览器和服务器之间的对话协议,它天生「无状态」——每次请求都相互独立,服务器不会主动记得上一秒的你;这既是设计上的简洁,也正是「登录态」这个问题的根源。
登录态问题的提出
想象一下上一节那家「失忆店员」便利店。一开始店员失忆也没啥大不了——你买瓶水、拿张报纸,他爱记不记。但有一天,店里挂出一块新招牌:
**「本店推出会员卡服务:充值 100 送 10 元,会员购物一律 8 折。」**
这下麻烦了。如果你充值 100 元办完会员,转身去买东西,店员问你:「会员卡呢?」——可是你根本没收到任何能证明你「已经是会员」的东西。下次你进店,店员照样问你要会员卡。在失忆店员的世界里,「会员」这件事根本不存在。
网站里的「登录」,就是这家店的「会员卡」。
一次真实的「登录后崩溃」
让我们把上一节的「失忆店员」放到真实的网页里走一遍。假设有个叫「小白网」的学习网站,你需要登录才能看自己的学习记录:
**第一步:访问登录页**
- 浏览器发出请求:「请把登录页面给我。」
- 服务器返回登录页,结束。此时你还没登录,一切正常。
**第二步:提交账号密码**
- 你在登录页填好账号密码,点「登录」。
- 浏览器发出请求:「这是我的账号密码,请验证。」
- 服务器查表,发现账号密码对得上,返回:「登录成功,欢迎小白!」
**第三步:点击「我的学习记录」**
- 浏览器发出新请求:「请把'我的学习记录'页面给我。」
- 服务器收到请求——但它已经完全忘记你刚刚登录过。
- 它不知道你是谁,所以它无法返回「你的」学习记录。
- 最朴素的处理是:把你踢回登录页,让你重新登录。
**第四步:刷新当前页面**
- 你刚刚刷了一下 F5,浏览器重新发出请求。
- 服务器再次失忆,再次把你踢回登录页。
flowchart TD
    A[打开登录页] --> B[提交账号密码]
    B --> C[服务器验证通过 欢迎小白]
    C --> D[点击我的学习记录]
    D --> E{服务器还记得我吗}
    E -->|忘了| F[请重新登录]
    E -.需要机制.-> G[服务器记得你是小白]
    F --> H[再次刷新页面]
    H --> I[服务器又忘了 再请登录]
**注意上面那个「需要机制」的虚线箭头**——它就是整张图的关键:当前 HTTP 协议下,服务器根本走不到右边那条路径。
这件事为什么严重?
你可能想:「不就多登录几次吗?」问题是登录态一旦断了,**所有需要「认人」的功能都会跟着断**:
- **个人主页**:看不到自己的资料。
- **购物车**:每刷新一次就清空——你刚挑好的商品全没了。
- **发帖评论**:服务器不知道你是谁,没法把评论挂在你名下。
- **权限操作**:付款、改密码、删除订单——任何「确认是本人」的动作都做不了。
换句话说,**没有登录态,就没有「个人化」的互联网**。微信不是你的微信、淘宝不是你的淘宝、邮箱不是你的邮箱——所有这些「是你的」的感觉,全都依赖一个前提:服务器得在某次登录之后、接下来的很多次请求里,依然「认得你」。
问题的本质
把这件事抽成一句话:**HTTP 自己没这个能力,但我们必须想办法让服务器「装出」记得我们的样子。**
注意关键词——「**装出**」。服务器本质上依然是失忆的。我们不可能真的给它装上记忆(那样代价太大,前面说过)。我们要做的,是**让浏览器在下一次请求时,主动带上某种「凭证」**,让服务器一看:「哦,原来是你。」
这个「凭证」到底是什么、长什么样、谁来发、谁来验、存哪里——这些就是接下来要聊的事。
**要点:**HTTP 天生「失忆」直接导致一个具体问题:登录后跳到任何页面、刷新任何一次,服务器都会把你当陌生人——所有需要「认人」的功能(个人主页、购物车、权限操作)全部失效。整章要解决的就是:**怎么让浏览器每次请求都主动带上某种「凭证」,让失忆的服务器也能认出我们**。
解决思路预览:三种凭证方案
上一节我们看到,「失忆店员」如果什么都不做,登录后跳转任何页面、刷新一下,服务器都立刻把你当陌生人——所有需要「认人」的功能(个人主页、购物车、权限操作)全部失效。
这节课的老板(也就是写服务器代码的工程师)当然不会接受这种体验。于是他们动脑筋:**既然服务器真的没法「记住」什么东西,那能不能让浏览器每次进来时,主动递上一张「证据」,让失忆的店员一看就反应过来「哦,是你啊」?**
答案是能。而且工程师们还真想出了不止一种办法——主流有三种思路。
方案一:Cookie 凭据(最朴素)
还是那个失忆店员,但他手上多了一个小抽屉,专门用来放「**小纸条**」。
- 第一次你登录成功,店员撕一张小纸条写上「这是小白」,塞进抽屉里;
- 下次你进店,店员没等你开口,就先把小纸条翻出来对一眼——「哦,小白啊」。
这张小纸条就是 **Cookie**。它本质上是**服务器给浏览器发的一张「身份凭据」**,浏览器每次访问这个网站时,会**自动**把这张小纸条塞进请求里交回去。
但问题也摆在这里:纸条上如果只写「小白」三个字,任何捡到这张纸条的人都能冒充他。所以光有 Cookie 还不够安全——这也是为什么大多数网站**不会单独**用 Cookie,而是把它和下一种方案搭配使用。
方案二:Session 小本本(服务器端记账)
还是失忆店员,但这回他多了一件装备——**一本挂在墙上的小本本**。本本上每一行都记着一个人:第 1 行是小白、第 2 行是阿花、第 3 行是阿灰……
- 第一次你登录成功,店员在本子上记下一行「**S001 → 小白**」,然后撕下一张只写着 **S001** 这个编号的纸条递给你;
- 下次你进店,把纸条递上去,店员拿起纸条一对本本——「S001……小白啊,欢迎。」
这套「**本本 + 编号纸条**」的组合,就是大名鼎鼎的 **Session 机制**。本子放在服务器那边,**服务器在这次会话期间是「记得东西」的**(虽然不是真记忆,但至少有一本随时能查的账);纸条上只是个**查本子用的编号**,丢了也无所谓,因为别人就算捡到纸条,也猜不到本子上对应的是谁。
这是过去十几年网站最主流的登录态方案。
方案三:Token 证件(自包含的身份证)
但本本方案有个麻烦:本子要店员自己记。如果同一时刻有成千上万人进店,墙上挂满了本子,店员累得不行。能不能**让本本也省掉,证件本身就自带信息**?
能。这就是 **Token**——你可以把它理解成**一张防伪身份证**。
这张身份证上不光有「小白」这个名字,还附着一段**店员能验证真伪的密文签名**。下次你进店,店员不用查任何本子,只需要用一种**算术**验一下这张身份证的签名——对得上,就是真的;对不上,假的。
这种「证件自包含、服务器不用存东西」的特性,让 Token 特别适合**跨网站、跨 App、跨设备**的场景——你拿同一张身份证去不同的地方,不同地方的店员都能认出你。
三种思路一张图
flowchart TD
    A[登录态难题 失忆服务器怎么认出老顾客] --> B[方案一 Cookie 凭据]
    A --> C[方案二 Session 小本本]
    A --> D[方案三 Token 证件]

    B --> B1[服务器发一张纸条给浏览器]
    B --> B2[纸条上可能就写了名字 风险高]
    B --> B3[几乎不单独用]

    C --> C1[服务器墙上有本本 记着谁是谁]
    C --> C2[纸条上只写查本子用的编号]
    C --> C3[过去十几年最主流的方案]

    D --> D1[证件自带信息 含防伪签名]
    D --> D2[服务器不用存本本 验签即可]
    D --> D3[适合跨站跨设备]
一点预告
三种方案不是非此即彼——Cookie 和 Session 基本是**搭着**用的(你很快会看到「Cookie 里存的就是 Session ID」这种说法);Token 也常常**借道** Cookie 把证件带回去(所谓的「把 Token 塞 Cookie 里」)。它们之间的关系,比「三选一」要微妙得多。
但那是后面要展开的事。这一节我们只需要记住一件事:**既然服务器必然失忆,就一定要有某种「凭证」在浏览器和服务器之间来回传递——而这种「凭证」有三种主流实现方式。**
**要点:** 解决 HTTP 失忆带来的登录态问题,核心思路是「让浏览器每次请求都主动带上某种凭证」。主流有三种:Cookie 凭据(最朴素的纸条)、Session 小本本(服务器端记账 + 编号纸条)、Token 证件(自包含的防伪身份证)。它们各有所长,常常配合使用。
学习笔记
HTTP 协议天生无状态
HTTP(超文本传输协议)是浏览器和服务器之间对话的方式:浏览器用 HTTP 向服务器「喊话」要网页或数据,服务器返回一个回应,结束。
「无状态」指每一次请求都是独立的、互不相关的。服务器处理完当次请求后不会主动记住你是谁、你刚才做了什么;下一次你再来,它照样把你当新客人。
flowchart LR
    A[浏览器 请求 login 页面] --> B[服务器 验证密码 返回成功]
    B -. 用户点击链接 .-> C[浏览器 请求 home 页面]
    C --> D[服务器 当作新访客处理]
无状态的设计原因与代价
- **设计初衷**:早期互联网只用来传文档、看看论文,每次请求都是「取个东西走人」的简单动作,服务器不需要保存任何状态。
- **好处**:服务器更简单(不维护用户状态表)、能同时服务更多人、服务器重启或换机器也不会因「忘了你」而出问题。
- **代价**:服务器自己永远不会主动记得你——登录、购买、看过的页面,统统会在下一秒被忘光。
登录态问题
HTTP 天生「失忆」直接导致:登录后跳到任何页面、刷新任何一次,服务器都会把当前请求当陌生人处理,所有需要「认人」的功能全部失效:
- **个人主页**:看不到自己的资料。
- **购物车**:刷新一次就清空,刚挑好的商品全没了。
- **发帖评论**:服务器不知道你是谁,没法把评论挂在你名下。
- **权限操作**:付款、改密码、删除订单——任何「确认是本人」的动作都做不了。
问题的本质:**HTTP 自己没这个能力**,但必须想办法让服务器「装出」记得我们的样子——具体做法是让浏览器在下一次请求时主动带上某种「凭证」。
三种凭证方案
方案一:Cookie 凭据
- 本质是**服务器给浏览器发的一张「身份凭据」**。
- 浏览器每次访问该网站时,会**自动**把这张小纸条塞进请求里交回去。
- 缺点:纸条上如果只写用户名(如「小白」),任何捡到纸条的人都能冒充。
- 实际中**几乎不单独用**,通常要和其他方案搭配。
方案二:Session 小本本
- 服务器那边挂着一本小本本,每行记录「编号 → 用户」(例如「S001 → 小白」)。
- 登录成功后,服务器在本子上记下一行,给浏览器一张只写**编号**的纸条。
- 下次请求,服务器拿纸条上的编号查本子,对上就认人。
- 纸条上只是查本子用的编号,丢了也无所谓——别人就算捡到纸条,也猜不到本子上对应的是谁。
- 是过去十几年网站最主流的登录态方案。
方案三:Token 证件
- 可以理解成**一张防伪身份证**,证件本身自带信息,且附带一段服务器能验证真伪的密文签名。
- 服务器不用查任何本子,只需用一种算术验一下签名——对得上就是真的,对不上就是假的。
- 「证件自包含、服务器不用存东西」的特性,使 Token 特别适合**跨网站、跨 App、跨设备**的场景:同一张身份证去不同地方都能被认出。
第 2 关 · Cookie:浏览器口袋里的「小纸条」
讲清 Cookie 是什么、怎么在浏览器和服务器之间传递、以及它有哪些关键属性。
Cookie 是什么
从上一节的坑说起
上一节我们留了一个大坑:HTTP 天生「失忆」,服务器处理完一次请求就把你忘光。那问题来了——平时我们登录淘宝、刷微博,为什么刷新页面、跳转链接,网站都还认得我们?
答案藏在浏览器口袋里的一张**小纸条**里。
Cookie:小纸条的诞生
Cookie 就是浏览器替每个网站保管的**一小段数据**。它的工作流程分三步:
- **服务器下发**:你第一次访问某网站,服务器验证通过后,在响应头里夹带一个叫 `Set-Cookie` 的字段,里面写着「这用户已经登录了,身份是某某某」。
- **浏览器保管**:浏览器收到这张「纸条」,把它存进一个**专门为该网站留的小格子**里。
- **自动带回**:之后你再访问这个网站的任何页面,浏览器都会**自动**把这张纸条塞进请求里(专业叫 `Cookie` 请求头),交给服务器。
这里有个关键直觉:服务器本身并没有「记住」你——它只是**信任**你交回来的纸条。每次请求都是一次「出示证件」的过程,状态写在纸条上,不存在服务器脑子里。
一个具体例子:登录淘宝
你打开 taobao.com,输入账号密码登录:
- 浏览器发送登录请求(账号 + 密码)
- 服务器验证通过,生成一段身份信息(比如 `userId=12345`),在响应头里写:`Set-Cookie: userId=12345`
- 浏览器把这段数据存进「淘宝」这个小格子里
- 你点开「我的淘宝」,浏览器**自动**在请求里带上 `Cookie: userId=12345`
- 服务器读到 `userId=12345`,知道是张三,返回张三的订单列表
之后你在淘宝里跳转几十个页面,浏览器每次都自动附带这张纸条。服务器从来不需要「记」你,每次只需要「认纸条」就行。
sequenceDiagram
    participant 浏览器
    participant 服务器
    浏览器->>服务器: 第1次请求 登录页
    服务器-->>浏览器: 响应 + Set-Cookie: user=张三
    Note over 浏览器: 把纸条存进淘宝的小格子
    浏览器->>服务器: 第2次请求 我的订单<br/>自动附带 Cookie: user=张三
    服务器-->>浏览器: 返回张三的订单
    浏览器->>服务器: 第3次请求 购物车<br/>自动附带 Cookie: user=张三
    服务器-->>浏览器: 返回张三的购物车
「为每个网站」这四个字很重要
浏览器里的小格子是**按网站分开**的:
- 淘宝的小格子 → 只在访问 `taobao.com` 时才带
- 微博的小格子 → 只在访问 `weibo.com` 时才带
- 知乎的小格子 → 只在访问 `zhihu.com` 时才带
淘宝的纸条**绝不会**自动出现在微博的请求里。这点对后面理解「跨域」至关重要——你的身份是按网站隔离保管的。
要点
- Cookie 是浏览器替每个网站保管的**一小段数据**;
- 第一次由服务器通过 `Set-Cookie` 头下发,之后浏览器在每次请求时**自动**带回;
- 服务器不是「记住了」你,而是「认纸条」。
Cookie 的关键属性
从「为每个网站保管」再往前走一步
上一节我们说:浏览器为每个网站都开了一个「小格子」,纸条不会乱跑。但这就引出一个新问题——**谁来决定这张纸条的使用范围**?
比如淘宝的纸条,能不能在 `tmall.com`(天猫)也用?能不能只在「我的订单」页面才用,别在首页用?能不能强制要求「走加密通道」传递?能不能禁止网页里的脚本偷看内容?
这些问题,全靠 Cookie 身上挂着的**四个属性**来回答。可以把一张 Cookie 想成一张实体卡片,**这四个属性就是卡背面的使用条款**——规定了「谁能用、哪能用、怎么传、谁能看」。
Domain:这张卡只认哪家公司
`Domain` 决定「这张纸条的归属网站」。比如淘宝服务器下发时写 `Domain=taobao.com`,那浏览器就只会在访问 `taobao.com` 的时候自动带上它。
但有个细节值得提一下:早期的 Cookie 规范里,Domain 前面可以加个点(比如 `Domain=.taobao.com`),本意是「兼容所有子站」。不过**现代浏览器(按 RFC 6265 实现)会忽略这个前导点**,写不写效果都一样,**不会因为带点就更广**。所以判断「这张卡能不能在另一个网站用」,看的不是「带没带点」,而是**那个网站在不在 Domain 域名之下**。
比如 `Domain=taobao.com` 会让 Cookie 出现在 `tmall.com`(天猫)、`ju.taobao.com`(聚划算)、`item.taobao.com` 这些**真正属于 taobao.com 子域**的网站上。这就是为什么你在天猫购物时不需要重新登录——它们共享同一张「母域名」。
> 小心一个常见误解:同一家公司的不同网站(比如淘宝的 `taobao.com` 和阿里速卖通的 `aliexpress.com`)**域名是各自独立注册的**,互相不是子域关系,Cookie 不会互通。
Path:这张卡只在哪层楼用
`Path` 决定「带不带」取决于**请求的路径**:
- `Path=/` → 访问这个网站的所有页面都带
- `Path=/order` → 只有访问 `/order` 开头(如 `/order/list`、`/order/detail`)的页面才带
类比一下:你公司大楼的门禁卡设为 `Path=/` 就是大厅入口,所有楼层通用;但如果只是某个部门的负责人,卡可能只设了 `Path=/hr`,那访问 `/finance` 时这张卡就不灵。
实际场景:很多网站把「敏感操作」的 Cookie 设为 `Path=/pay`,这样只有付款相关页面才带,平时浏览商品时不会暴露身份信息。
Secure:只能走加密通道
`Secure` 是个开关,加了它之后,**这张 Cookie 只在 HTTPS 连接里才传输**。HTTP 明文链接下,浏览器宁可扔掉也不送。
为什么这么严?因为 HTTP 是「明信片」——沿路任何一台路由器都能看到纸条内容;HTTPS 才是「密封信封」,别人看不到。所以**只要 Cookie 涉及登录态、身份信息,几乎一定要开 Secure**。
HttpOnly:JS 看不到纸条内容
`HttpOnly` 是个防偷看的开关。开了它之后,**网页里的 JavaScript 脚本读不到这张 Cookie**。
`document.cookie` 拿到的是「空」——脚本只看到空气,看不到纸条上的字。
这听起来挺反人性,网站自己的脚本都读不到,那有什么用?
有用的:HTTP 请求是浏览器**自动**带上 Cookie 的,**不经过 JS**。所以服务器依然能读到。但网页里嵌入的第三方脚本(广告、统计代码、恶意脚本)就拿不到这张纸条了——这是一道非常关键的防线。
类比:这张纸条被「封在了信封里」再交给浏览器,浏览器自动塞进信封送出去,但**任何想中途拆信偷看的人都被禁止**。
四个属性合起来看
flowchart TD
    A[一张 Cookie 卡片] --> B[Domain<br/>哪家网站能用]
    A --> C[Path<br/>哪些路径要带]
    A --> D[Secure<br/>只走 HTTPS]
    A --> E[HttpOnly<br/>JS 看不到内容]
    B --> F[划定归属范围]
    C --> F
    D --> G[划定传输方式]
    E --> H[划定可见性]
    F --> I[四个属性联手<br/>画出 Cookie 的完整边界]
    G --> I
    H --> I
四个属性不是各自为政,它们**联手画出了 Cookie 能在哪里出现、以什么方式出现、被谁看见**的完整边界。
一个具体例子:电商网站的「登录态 Cookie」
你登录淘宝,服务器下发的纸条可能是这样:
Set-Cookie: sid=abc123; Domain=taobao.com; Path=/; Secure; HttpOnly
读起来就是一句话:
> 「这张纸条属于 taobao.com 旗下所有子域网站,全站都带,只走 HTTPS 加密通道,前端脚本看不见内容。」
一条纸条,四个属性,就把它的来去范围规定得清清楚楚。
要点
- Cookie 的四个关键属性——Domain、Path、Secure、HttpOnly——共同决定了「这张纸条的边界」:Domain 划定**归哪家网站**、Path 划定**走哪些路径**、Secure 划定**怎么传**、HttpOnly 划定**谁能看**。
- Domain 前的「点」在现代浏览器里没有特殊含义,判断是否共享要看**真正是不是子域关系**。
SameSite:跨站请求时是否自动带上
一个你大概经历过的场景
你大概遇到过这种情形:在微博刷到一个淘宝商品链接,点进去一看——咦,怎么没登录?又或者从某个外部网站点进另一个网站,对方却认得你是会员。
这两种「带不带登录态」的反差,就跟今天要讲的属性有关——**`SameSite`**。它专门管一件事:**跨站请求时,浏览器要不要自动把这张 Cookie 一起带过去**。
先说「跨站」是什么
所谓「跨站」,简单说就是——**用户当前所在的网站(叫 A 站)和请求要发往的网站(叫 B 站),不是同一个「家族」**。
比如:
- 你在 `news.com` 看新闻,文章里有个链接点去 `shop.com` —— 这是跨站
- 你在 `taobao.com` 浏览,页面里嵌了一张 `cdn.com` 的广告图 —— 这也是跨站
- 你在 `github.com` 编辑代码,点了菜单跳到 `github.com/settings` —— 这不是跨站(同一站)
跨站请求每天发生无数次:点链接、嵌图片、嵌 iframe、AJAX 调接口……**每一次跨站,浏览器都要做一个决定:这趟要不要把对方站点的 Cookie 一起带上?**
SameSite 的三档开关
`SameSite` 就是用来**回答这个问题**的——它是 Cookie 的第五个属性,给浏览器一个明确的指令。它有三个值,像三档开关:
Strict(严格):跨站一概不带
最严的一档。**只要不是同站请求,不管你是点链接、嵌图片、AJAX 调用,统统不带你。**
后果很直接:用户从别的网站点过来时,**目标网站看不到他的登录态**,要重新登录。
Lax(宽松):点链接带,其他不带
中庸一档。**用户主动点链接、打开新页面这种「真要过去」的行为,带 Cookie**;但**悄悄发起的跨站请求**(图片、iframe、AJAX 之类)**不带**。
这是现代浏览器的**默认值**——Chrome 80+ 起,没显式写 SameSite 的 Cookie 自动按 Lax 处理。
None(无限制):都带,但必须开 Secure
最松的一档。**跨站也带、同站也带,全带。**但有代价:必须**同时**带上 `Secure` 属性(也就是只能 HTTPS 传输),否则浏览器直接拒绝接收。
这种一般是「必须跨站工作」的场景,比如嵌入第三方的支付按钮、社交分享按钮等。
一张图看清三档差异
flowchart TD
    A[跨站请求发生时] --> B{SameSite 是什么值?}
    B -->|Strict 严格| C[一律不带]
    B -->|Lax 宽松| D[点链接打开新页面: 带<br/>跨站图片 iframe AJAX: 不带]
    B -->|None 无限制| E[都带<br/>必须同时开 Secure]
一个具体场景:你点进淘宝
你正在 `weibo.com` 刷微博,看到一个淘宝商品链接点了过去。淘宝服务器下发的登录 Cookie 上写的是 `SameSite=Lax`(也就是默认值),会发生什么?
- 浏览器导航到 `taobao.com`——这是一个「点链接打开新页面」的行为
- 浏览器判断:「跨站,但是 Lax 允许点链接带」
- **Cookie 跟过去了**——你看到自己已经登录的淘宝
如果这个 Cookie 上写的是 `SameSite=Strict` 呢?
- 浏览器判断:「跨站 + Strict = 不带」
- **Cookie 留在了 `weibo.com` 的来路上,没跟过去**
- 你看到的是**未登录的淘宝首页**,需要重新登录
这就是 SameSite 在「带不带」层面最直接的影响:**它决定用户从外部点进来时,目标网站认不认他**。
要点
- `SameSite` 决定跨站请求时**是否自动带上此 Cookie**——只关乎「带不带」的传输行为。
- 三档:`Strict`(跨站一律不带)、`Lax`(点链接带,其他不带,**现代浏览器的默认**)、`None`(都带,但必须开 Secure)。
Cookie 的生命周期
Cookie 的生命周期
先想一个常见的对比
你登录了某网站,**关掉浏览器**——
- 第二天再打开 A 网站:**还登录着**,「记住我」真管用
- 第二天再打开 B 网站:**得重新登录**,安全起见
这两种不同表现,不是服务器有什么神奇记忆,**就是 Cookie 自己定好的「死期」不一样**。Cookie 有两种活法:**会话 Cookie** 和**持久 Cookie**。
会话 Cookie:临时手环
你在游乐场戴过那种「当日有效」的临时手环吧?进园戴上,玩到闭园剪掉,**作废**。**会话 Cookie 就是这种「临时手环」**。
它的特征简单:**服务器下发 Cookie 时没写 Expires,也没写 Max-Age**:
Set-Cookie: session_id=abc123; HttpOnly
这种 Cookie 的寿命跟着**浏览器进程**走——**浏览器一关,它就从内存里被清掉**。下次再开浏览器访问,浏览器手里已经没这张小纸条,服务器自然认不出你。
常见场景:网银、临时登录、不希望「忘了退」的场合。
持久 Cookie:年卡
跟临时手环相对的,是**年卡**——办卡时定好一年有效期,这一年里随时凭卡进园。**持久 Cookie 就是这种「年卡」**,它有两种方式给浏览器「定死期」:
Expires:写明「几月几号死」
Set-Cookie: uid=xyz789; Expires=Wed, 25 Dec 2026 12:00:00 GMT
绝对时间,告诉浏览器「到那天,Cookie 失效」。
Max-Age:写明「还能活多少秒」
Set-Cookie: uid=xyz789; Max-Age=604800
相对时间,604800 秒 = 7 天,告诉浏览器「从现在起 7 天后失效」。
**两个都写的时候,浏览器以 Max-Age 为准。**
一个具体例子:登录页的「记住我」
你登录时常见的小勾选框「**记住我 7 天**」,背后就是这么点事:
- **不勾**:下发的 Cookie 没 Expires/Max-Age → 会话 Cookie → 关浏览器就没
- **勾**:下发的 Cookie 写了 `Max-Age=604800` → 持久 Cookie → 7 天内关浏览器再开仍登录
**不是服务器在记你,是浏览器口袋里的那张小纸条上写着「7 天后失效」**。
一个容易踩的坑
「关掉浏览器」严格说是**关掉最后一个浏览器窗口、且不恢复会话**。只关一个标签页、或者下次启动时浏览器「恢复上次会话」——会话 Cookie 都可能还在。
所以更准确的说法是:**会话 Cookie 在浏览器进程正常结束时消失**,而不是「按一下关闭键就没」。
一图区分两种 Cookie
flowchart TD
    A[服务器下发 Cookie] --> B{写了 Expires<br/>或 Max-Age 吗?}
    B -->|没写| C[会话 Cookie<br/>临时手环<br/>关浏览器进程就没]
    B -->|写了| D[持久 Cookie<br/>年卡<br/>到时间才失效]
    D --> E{用哪个字段?}
    E -->|Expires| F[绝对时间<br/>几月几号]
    E -->|Max-Age| G[相对时间<br/>多少秒后]
要点
- **会话 Cookie**(没写 Expires/Max-Age)= 临时手环,浏览器进程正常结束就消失。
- **持久 Cookie**(写了 Expires 或 Max-Age)= 年卡,按设定时间失效,关浏览器不影响。
- 「记住我 7 天」= 把原本是会话 Cookie 的那张加上 `Max-Age=604800`。
生活类比:游乐园手环
进园戴手环——你其实已经会 Cookie 了
你去过游乐园吗?回想一下这趟流程:
- **买票进门**:售票员给你手腕上扣一个手环
- **玩各个项目**:每个项目入口的阿姨**只扫一眼你手腕**,不问身份证、不报名字,就能认出「你是今天进园的人」
- **离园或过期**:手环剪掉或到期作废,下次再来得重新买票
**这一整套流程,就是浏览器登录态的 Cookie 在干的事**——只是把游乐园换成了网站,把手腕换成了浏览器口袋。
一一对应:手环 vs Cookie
把这套类比拆开看,**每一环都对得上**(先列对比,再分小段讲每对关系):
flowchart LR
    A[游乐园] -->|对应| B[网站]
    C[门票 进门] -->|对应| D[登录 服务器下发 Set-Cookie]
    E[手腕上的手环] -->|对应| F[浏览器口袋里的 Cookie]
    G[每个项目扫手环] -->|对应| H[每次请求自动带 Cookie]
    I[手环过期/剪掉] -->|对应| J[Cookie 失效 需重新登录]
1. 进园 = 登录
你买票进园,相当于你在网站点「登录」、提交账号密码。售票员/服务器**确认你是你**之后,发给你凭证——
- 游乐园给的是**手环**
- 服务器给的是**Cookie**(通过 `Set-Cookie` 响应头下发)
你**不用每次报身份证**、**不用每次报密码**,因为凭证在你身上(手在手腕上、口袋在浏览器里)。
2. 玩项目 = 后续请求
进了园后,你去玩过山车、旋转木马——**每个项目入口都自动认你**。他们怎么认?**低头看你手腕上手环**。
浏览器也一样:你登录后访问同一个网站的其他页面、点其他按钮——**浏览器自动在每个请求里把那张小纸条(Cookie)塞进请求头**。服务器低头一瞄,知道是你,**不用让你重新输密码**。
这就是「登录态跨页面维持」最朴素的样子。
3. 离园/手环作废 = Cookie 失效
你玩完出园,**手环要么剪掉,要么过期作废**——凭证没了,下次再来得重新买票。
Cookie 也是:
- **会话 Cookie**:关掉浏览器进程,手环就剪了
- **持久 Cookie**:到 `Expires` / `Max-Age` 那天,手环就过期了
凭证作废后,浏览器手里没纸条了,服务器就**认不出你**——你看到的就是「请重新登录」。
一个完整例子:从登录到退订订单
想象你在某电商网站:
- 你在**登录页**输账号密码,**服务器验证通过**,下发 Cookie:`Set-Cookie: sid=xxx; HttpOnly`
- 你跳到**首页**,浏览器自动带上那张 Cookie,服务器认出你,显示「你好,小王」
- 你点进「**我的订单**」,浏览器**又自动带上那张 Cookie**,服务器还是认你,把订单列出来
- 你退出登录,服务器下发**让 Cookie 失效**的指令(一般是 `Max-Age=0`),相当于**剪掉手环**
- 你再点「我的订单」,浏览器没 Cookie 可带,服务器说「请先登录」
**全程你没重复输过密码,跨了 N 个页面登录态都还在**——这都是那张小纸条(Cookie)的功劳。
为什么这个类比值得记
游乐园手环的三个特点,**就是 Cookie 的三个本质**:
- **凭证跟着用户走**(手腕 / 浏览器口袋),不靠用户每次自报家门
- **每次需要时由场地/服务器核验**(扫手环 / 看请求头),自动完成
- **有寿命**(手环可能剪掉或过期,Cookie 也会失效)
记不住 Cookie 的细节没关系,但**记住这张「游乐园手环」图景**——以后别人问你「登录态怎么维持的」「为什么关浏览器就要重登」,你都能三句话讲明白。
要点
**Cookie 做的事 = 游乐园手环做的事**:登录时下发凭证、之后每次请求浏览器自动带上、凭证过期或作废就需重新登录。
学习笔记
Cookie 学习笔记
Cookie 是什么
Cookie 是浏览器替每个网站保管的一小段数据。
**工作流程三步**:
- **服务器下发**:首次访问某网站,服务器验证通过后在响应头里设置 `Set-Cookie` 字段,写着身份信息
- **浏览器保管**:存进一个专门为该网站留的小格子里
- **自动带回**:之后每次访问该网站任何页面,浏览器自动在请求头里附带这条 Cookie
**核心直觉**:服务器本身并没有「记住」你,只是信任你交回来的纸条。每次请求都是「出示证件」,状态写在纸条上,不在服务器脑子里。
**按网站隔离**:浏览器的小格子按网站分开——淘宝的纸条不会自动出现在微博的请求里。身份按网站隔离保管。
Cookie 的关键属性
一张 Cookie 相当于一张实体卡片,属性就是卡背面的使用条款。
Domain:归属网站
`Domain` 决定 Cookie 的归属网站。例如 `Domain=taobao.com`,浏览器只在访问 `taobao.com` 时自动带上。
- 现代浏览器(按 RFC 6265)忽略 Domain 前导点(`Domain=.taobao.com`),写不写效果一样
- `Domain=taobao.com` 会让 Cookie 出现在真正的子域上(如 `tmall.com`、`ju.taobao.com`、`item.taobao.com`),所以天猫购物不需要重新登录
- 同公司不同独立注册域名(如 `taobao.com` 与 `aliexpress.com`)不构成子域关系,Cookie 不互通
Path:使用路径
`Path` 决定请求的路径满足什么条件时才带上 Cookie:
- `Path=/` → 访问该网站所有页面都带
- `Path=/order` → 只有访问 `/order` 开头的页面才带
实际场景:把敏感操作的 Cookie 设为 `Path=/pay`,只有付款相关页面才带。
Secure:加密通道
`Secure` 是开关。加上后,Cookie 只在 HTTPS 连接里传输,HTTP 明文下浏览器直接扔掉。涉及登录态、身份信息的 Cookie 几乎一定要开 Secure。
HttpOnly:防 JS 读取
`HttpOnly` 开启后,网页里的 JavaScript 脚本读不到这张 Cookie(`document.cookie` 拿到的是空)。
但 HTTP 请求是浏览器自动带上 Cookie 的,不经过 JS,所以服务器依然能读到;网页里嵌入的第三方脚本(广告、统计、恶意脚本)拿不到。
SameSite:跨站请求行为
`SameSite` 管一件事:跨站请求时,浏览器要不要自动带上这张 Cookie。
**跨站**:用户当前所在网站(A 站)与请求目标网站(B 站)不是同一个「家族」。
三档开关:
| 值 | 行为 | |---|---| | Strict 严格 | 跨站一概不带 | | Lax 宽松 | 点链接打开新页面时带;跨站图片、iframe、AJAX 不带(Chrome 80+ 起默认值) | | None 无限制 | 跨站同站都带,但必须同时开 Secure |
Cookie 的生命周期
Cookie 有两种活法:
会话 Cookie(临时手环)
服务器下发时没写 `Expires` 也没写 `Max-Age`。寿命跟着浏览器进程走——浏览器进程正常结束就从内存里清掉。
常见场景:网银、临时登录。
持久 Cookie(年卡)
通过两个字段定死期:
- `Expires`:绝对时间(几月几号死),例如 `Expires=Wed, 25 Dec 2026 12:00:00 GMT`
- `Max-Age`:相对时间(还能活多少秒),例如 `Max-Age=604800`(7 天)
两个都写时,浏览器以 Max-Age 为准。
**「记住我 7 天」背后的机制**:勾选时下发带 `Max-Age=604800` 的 Cookie;不勾则下发会话 Cookie。不是服务器在记你,是浏览器口袋里的纸条上写着失效时间。
**注意**:会话 Cookie 在浏览器进程正常结束时消失,而不是「按关闭键就没」——只关一个标签页或浏览器恢复上次会话时可能还在。
第 3 关 · Session:服务端的「记忆小本本」
理解 Session 是服务器端的状态存储、SessionID 是怎么通过 Cookie 跨请求传递「你是谁」的关键。
Session 是什么
Session 是什么
上一关你学到:Cookie 是浏览器口袋里的「小纸条」——服务器自己不记事,全靠浏览器每次自报家门。但纸条这东西毕竟揣在用户身上,能被看见、能被改写,没法藏太多秘密。那如果服务器自己也开一本小本子呢?这就是 Session。
先有直觉:图书馆借书
想象你去图书馆办借阅。门口管理员递给你一张小卡片,卡片上只写着一个编号。你口袋里没记任何书——你只是揣着这张卡。每当你借书、还书、续借,管理员在自己的本子里翻到你的编号那一页,添一笔。
书单全在管理员的本子里,你手里只拿着编号牌。Cookie 和 Session 的关系就是:你手里的卡片 + 管理员的本子。Cookie 是浏览器口袋里的那张纸条,Session 是服务器自己那本小本本。
Session 的正式定义
**Session(会话)** 是服务器为每一个来访的浏览器开辟的一块存储空间,专门用来记录「这个会话是谁、什么时候开始的、目前是什么状态」。
三个关键点:
- **「每一个」**:不管你有没有登录,服务器都会给你开一个 Session。匿名访客也有——只是本子上写的是「没名字的访客 #3847」,不是某个具体用户。
- **「服务器开辟」**:这块存储活在服务器上,不是浏览器口袋里。浏览器看不见里面有什么,也改不了。
- **「会话」**:从你打开这个网站那一刻开始,到你关掉浏览器、或者一段时间不动,Session 就结束了。中间无论你点了多少页面、刷新多少次、跳到哪里,都属于同一个 Session。
Session 里都记些什么
服务器在自己的小本子上为每个 Session 留一页,上面通常会写:
| 字段 | 类比 | 例子 | |---|---|---| | SessionID | 这一页的页码 | `sess_abc123` | | 创建时间 | 这一页是几点开的 | `14:32:01` | | 最后活动时间 | 上次翻到这一页的时间 | `14:35:22` | | 用户身份 | 这一页是哪位顾客的 | `user_5678`(登录后填上) | | 状态数据 | 临时记的事情 | 购物车里的三件商品 |
登录前,**用户身份那栏是空的**,但购物车等临时数据可能已经记上了(很多网站在你没登录时也能加购物车)。登录成功的那一刻,服务器在这页上补写上你的名字,把那一行从「匿名访客」改写成「张三」。
为什么需要 Session
服务器天生「失忆」——上一节讲过,HTTP 协议本身不保留任何上下文。Cookie 让浏览器每次自报家门,但 Cookie 上的信息是暴露在外的,浏览器端可以读、可以改。把所有用户数据都塞进 Cookie 是不行的:
- 存不了太多东西(每条 Cookie 一般不超过 4KB,每次请求都要来回带)
- 不能存敏感信息(用户能改)
- 也不能存大件物品(一张纸条装不下整个购物车)
Session 的思路是:浏览器口袋里**只放一个编号(SessionID)**,真正的身份信息和状态全藏在服务器自己的本子里。每次你出示编号,服务器才去本子里翻出那页——外人看不见里面的内容,也没法改。
一个具体场景
你在淘宝首页逛,没登录。看到一件衣服点了「加入购物车」。
flowchart LR
    A[浏览器首次访问taobao.com] --> B[服务器创建新Session 编号sess_xxx Set-Cookie下发]
    B --> C[浏览器收到Cookie sess_xxx 存进小格子]
    C --> D[用户点击 加入购物车]
    D --> E[请求里自动带Cookie sess_xxx]
    E --> F[服务器查到sess_xxx对应那页 写上购物车 红色毛衣 1件]
整个过程你**没有登录**,但购物车里的东西被记住了——因为服务器在自己的小本子上悄悄记了一笔。下次你刷新页面、跳到详情页再回来,那件红色毛衣还在购物车里,因为它活在服务器那页 Session 里,不是活在你浏览器里。
**要点**:Session 是服务器为每个来访者(包括匿名访客)开辟的一块服务器端存储,记录着「这个会话是谁、何时开始、目前什么状态」;它和浏览器口袋里的 Cookie 配合,一个记编号,一个存内容。
SessionID:记忆本的编号牌
SessionID:记忆本的编号牌
上一节我们说,服务器给每个来访者开一页小本子。但你想想——管理员手里的小本子有几十页、几百页,凭什么你出示卡片的时候,他就能精准翻到属于你的那一页?靠的就是**页码**。
SessionID 就是这个页码。
什么是 SessionID
**SessionID** 是服务器为每一个 Session 自动生成的一串唯一编号,长得像这样:
sess_a8f3e2b9c1d4f5e6a7b8c9d0e1f2a3b4
你不需要记住它,浏览器会替你揣着。你也**读不出它有什么含义**——它不是你的名字、不是你的账号、不是密码,就是一串看似无意义的随机字符串。它的唯一作用就是「**当下次你来的时候,凭这个串找到你那一页**」。
这就像图书馆的借阅卡上只印着「No. 03847」——你不会从 03847 这个号码里推出你的姓名、年龄、借过什么书。它就是一个查找用的钥匙,本身不含任何业务信息。
浏览器口袋里装的,就是这个 SessionID
回顾上一节的关键发现:浏览器口袋里的 Cookie 只是一张纸条,而这张纸条上**不记任何用户信息**。那它到底记什么呢?
答案就是:**记的就是 SessionID 这一串字符**。
这就把整件事串起来了:
flowchart LR
    A[服务器的小本本<br/>每页是一次Session] -->|记着| B[SessionID a8f3e2b9...]
    B -->|通过Set-Cookie下发| C[浏览器口袋里的Cookie<br/>纸条上只写这一行]
    C -->|下次请求自动带回| D[服务器拿SessionID去翻小本本]
    D -->|查到对应那页| E[才知道你是谁 购物车里有什么]
你看,这其实是个**两步跳转**:
- 第一步:浏览器 → 把 SessionID 出示给服务器
- 第二步:服务器 → 拿 SessionID 去自己的小本子里翻
浏览器根本不知道、不关心、不持有「你是谁」「购物车里有什么」这些信息。它只负责把那个编号递过去。
为什么只放编号,不放真实信息
你可能会想:浏览器口袋里既然有空间,为什么不直接把「用户张三」也写进去,下次就不用查本子了?三个原因:
- **存不下**:Cookie 本身有 4KB 左右的容量限制(一条 Cookie),写不下购物车、用户偏好这些大件物品。
- **改得了**:浏览器端的东西用户能改、能看。用户名、地址、权限这些敏感信息露在外面,等于把家门钥匙挂在门外。
- **对不上**:如果身份信息存在浏览器里,那用户改了名字、换了地址、调整了权限,浏览器口袋里的老数据就和服务器对不上——而编号永远不会变,只是它指向的那一页内容在变。
SessionID 这串字符本身没意义,所以即使被外人看到、即使被复制走,它里面没有「张三」这三个字,没有密码,没有任何可以**直接伪造身份**的信息。真正的身份数据全部锁在服务器的小本子里。
一个具体场景
打开淘宝首页的那一瞬间,浏览器其实啥也没有——口袋里空空如也。请求发到淘宝服务器,服务器做了一连串动作:
flowchart TD
    A[浏览器首次访问taobao.com<br/>请求里没带任何Cookie] --> B[服务器发现这是个新访客]
    B --> C[生成一个随机长字符串 sess_xyz789abc...]
    C --> D[在小本子上新开一页 写上这个SessionID]
    D --> E[在响应头里写 Set-Cookie sess_xyz789abc...]
    E --> F[浏览器收到 自动把这一行存进Cookie小格子]
然后你点了「加入购物车」——这次请求里,浏览器**自动**把 `sess_xyz789abc...` 塞在 Cookie 字段里发给服务器。服务器拿这个编号去小本子里一翻,哦,找到了,就是这位,给购物车添一件红色毛衣。
整个过程中,浏览器**始终只知道那一串乱码**,从来不知道购物车里有什么、用户叫什么。
**要点**:SessionID 是服务器给每个 Session 配的唯一编号,浏览器口袋里的 Cookie 实际只装这个编号;真正的身份和状态数据全在服务器的小本子里,浏览器只是个「传话的人」。
登录态如何用 Cookie 加 Session 维持
登录态如何用 Cookie 加 Session 维持
上一节我们讲到 SessionID 是浏览器口袋里那串没意义的编号。但你也许还心存疑虑:那个「查小本本认人」具体怎么发生的?未登录和已登录的状态,在服务器的小本本里到底有什么区别?这一节我们就把整个过程从头到尾走一遍。
登录前:小本本里就有你的匿名页
很多人以为「点登录按钮之前,服务器不认得我」。其实不是。你打开淘宝首页的那一刻,服务器就已经给你开了一页小本子,分配了一个 SessionID,写进你的 Cookie 了。只不过这一页上没有写你的名字——它是匿名的,记录的只是「这位访客从哪个 IP 来、第一次访问时间、看了哪几个商品」这些浏览痕迹。
也就是说,登录之前,你已经是有 Session 的人了,只是没「名分」。
点击登录的那一瞬间
你在登录框里敲下用户名和密码、点下「登录」按钮,请求发到服务器。服务器做三件事:
- **核对身份**:拿你提交的用户名密码去用户表里查,能对上 → 通过
- **修改那一页**:找到刚才那张匿名 Session 页(凭 SessionID 翻本子),在这一页的某个字段里写下「用户已登录,user_id=张三,登录时间 14:30」
- **回写 Set-Cookie**:服务器不改 SessionID(编号不变),但在响应头里附带 `Set-Cookie: sess_xyz789abc...`——浏览器收到后,把这串编号更新到自己的 Cookie 格里
> 关键洞见:登录本身没有创建新的 Session,只是给原来的匿名页「转正」。SessionID 没变,浏览器口袋里的编号没变,变的是服务器小本本里那一页的内容。
登录之后:你点任何页面都已登录
接下来你点「我的淘宝」、「购物车」、「已买到的宝贝」——每一个请求里,浏览器都自动把那个 SessionID 塞在 Cookie 字段里带回。服务器做这件事:
flowchart LR
    A[你点 我的淘宝] --> B[请求里自动带上Cookie<br/>sess_xyz789abc...]
    B --> C[服务器拿SessionID去翻小本本]
    C --> D{查到了 那一页上写着 user_id=张三}
    D -->|是| E[返回张三的我的淘宝页面]
    D -->|没查到| F[返回 请先登录 页面]
服务器每收到一个请求,就只问一个问题:这个 SessionID 对应的那一页上,写没写 user_id?写了 → 当你已经登录来处理;没写 → 视为匿名访客。
所以「登录态」的本质,就是服务器小本本里那一页 Session 记录上,有没有写 user_id 这一行字。
一次完整的登录-浏览流程
把所有环节串起来:
flowchart TD
    A[第1步 打开首页 匿名访客] -->|服务器生成SessionID aaaa| B[浏览器存Cookie aaaa<br/>小本本匿名页]
    B -->|第2步 输入账号密码登录| C[服务器核对 通过]
    C -->|第3步 修改小本本那一页<br/>写上 user_id=张三| D[小本本同一页 现在有名字了]
    D -->|Set-Cookie aaaa 不变| E[浏览器 Cookie 没变化 还是aaaa]
    E -->|第4步 点我的淘宝| F[请求自动带回 aaaa]
    F -->|服务器翻本子 查 user_id| G[返回张三的个人页]
你发现没?步骤 1-2 浏览器口袋里的 Cookie 都没变(都是 aaaa),变的纯粹是服务器那一页上有没有「张三」这两个字。浏览器全程不知道、不持有、也不展示用户的任何信息。
常见误解澄清
- 「登录后,浏览器记住了我的账号」→ 错,浏览器只记住了 SessionID 那串乱码
- 「我换个浏览器就要重新登录」→ 对,但原因不是账号没记住,而是新浏览器口袋里没有那张写着 SessionID 的纸条
- 「关闭浏览器就退出登录了」→ 不一定。这取决于 Session 过期策略,不是浏览器决定的——下一节细讲
**要点**:登录本质上是「服务器小本本上那一页 Session 记录被填上了 user_id」;浏览器口袋里的 SessionID 在登录前后始终未变,每一次的「我已登录」都是服务器翻本子查出来的。
Session 的过期与失效
Session 的过期与失效
上一节我们搞懂了登录态的「常态」——服务器翻小本本认人。但这个小本本不是永久存在的,它会过期、会被撕掉。这一节我们就把 Session 怎么「不再有效」讲清楚。
三种让 Session 失效的方式
服务器小本本上某一页 Session 记录,会在三种情况下被撕掉或作废:
**第一种:超时未活动(最常见)**
服务器给每一页 Session 都设了一个「保质期」。比如你登录后 30 分钟内没有任何操作(没点页面、没发请求),服务器就认为「这个人可能走开了」,主动把小本本上你的那一页撕掉。
你也许会问:超时是从登录那一刻算起,还是从最后一次操作算起?答案是后者——滑动窗口。比如 14:00 登录、14:20 点了一下「购物车」、14:45 又点了一下「已买到」,那 Session 每次都会被「续命」到 30 分钟之后;只要你持续不操作,30 分钟才会真的过期。
**第二种:用户主动退出**
你点「退出登录」按钮时,浏览器发一个「我要登出」的请求给服务器。服务器做两件事:
- 立刻撕掉小本本上对应的那一页 Session 记录
- 在响应头里附带 `Set-Cookie: sess_xxx=; expires=过去时间`,让浏览器把那串 SessionID 也当场作废
这两步缺一不可。如果只撕服务器那一页而不让浏览器清 Cookie,下次你点任何页面,浏览器还是会乖乖把那串已经无效的 SessionID 带回去——服务器翻本子发现「查无此页」,会把它当成新的匿名访客再开一页(旧的虽然没了,但新的 SessionID 又会被写进 Cookie 覆盖)。所以完整退出需要服务器和浏览器双方配合。
**第三种:服务器定期清理**
服务器的小本本不是无限大的,每隔一段时间(比如每天凌晨)会有一场大扫除,把所有已经过期的页面集中清理掉。这就像图书馆定期清理逾期未还的借书记录——超期的不管你认不认,都得清掉,腾出空间给新会话。
flowchart TD
    A[Session 失效的三个原因] --> B[超时未活动<br/>比如30分钟无操作]
    A --> C[用户主动退出<br/>点退出登录按钮]
    A --> D[服务器定期清理<br/>过期记录清掉腾空间]
    B --> E[小本本那一页被撕掉]
    C --> E
    D --> E
    E --> F[浏览器还拿着过期的SessionID]
    F --> G[下次请求带回去 查无此页]
    G --> H[服务器当作新访客<br/>或要求重新登录]
一个具体场景
小王 9:00 在公司电脑上登录了公司系统,然后去开会、午饭、出差——整整 4 个小时没碰过电脑。13:30 回来想点「我的工作台」。
他点下去的那一刻,浏览器自动把那个 SessionID 塞进请求里带回服务器。但服务器的小本本上,9:30 左右那一页 Session 记录因为 30 分钟无操作,已经被撕了。服务器查不到对应记录,于是返回「请先登录」的页面。
注意:小王电脑的 Cookie 文件里,那串 SessionID 这一刻可能还在(浏览器没主动删它)。但它已经是一张「指向已撕掉页面」的纸条,没有任何意义。服务器下次若真给他开了新会话,会写一个**新的** SessionID 进 Cookie 覆盖旧的。
容易混淆的点
- **「Cookie 被删」≠「Session 过期」**:Cookie 还在但 Session 已过期很常见。主动退出时两边通常一起清;超时则只清服务器那一页,浏览器 Cookie 暂时还在。
- **「记住我 / 30 天免登录」不是 Session**:那种长有效期通常用的是另一种机制(Token),不是服务器的小本本——下一关会讲。
- **为什么清浏览器 Cookie 也能退出登录**:因为你把唯一通向小本本那页的「纸条」扔了,服务器无从认你,自然要你重新登录。
**要点**:Session 失效分三种——超时、主动退出、定期清理;浏览器 Cookie 是否被清,取决于触发原因;Cookie 还在但 Session 已过期时,服务器查无此页就会要求重新登录。
学习笔记
一、Session 的定义与三关键点
Session(会话)是服务器为每一个来访浏览器开辟的一块存储空间,用来记录「这个会话是谁、什么时候开始的、目前是什么状态」。三个关键点:
- 「每一个」:匿名访客也有 Session,只是本子上写的是「没名字的访客 #3847」。
- 「服务器开辟」:存储活在服务器上,浏览器看不见、改不了。
- 「会话」:从打开网站那一刻开始,到关闭浏览器或一段时间不动就结束。
卡片只写编号,书单全在管理员的本子里
卡片只写编号,书单全在管理员的本子里。Cookie(浏览器口袋的纸条)对应卡片,Session(服务器的小本本)对应本子。
三、Session 记录的字段
服务器为每个 Session 在小本子上留一页,通常包含:
- SessionID:页码,如 sess_abc123
- 创建时间:这一页几点开的
- 最后活动时间:上次翻到这一页的时间
- 用户身份:登录前为空,登录后填上 user_id
- 状态数据:临时记录,如购物车里的商品
四、为什么需要 Session(Cookie 的局限)
HTTP 协议本身不保留上下文,Cookie 让浏览器每次自报家门,但 Cookie 信息暴露在外:
- 容量限制:每条 Cookie 一般不超过 4KB,每次请求都来回带
- 浏览器端可读、可改,敏感信息不能放
- 装不下购物车等大件物品
Session 的思路:浏览器口袋里只放一个编号(SessionID),真实身份和状态全藏服务器本子里。
五、SessionID 的本质
SessionID 是服务器为每个 Session 生成的唯一随机字符串,作用是「下次来访时凭这个串找到属于你的那一页」。
- 本身无意义:不包含姓名、账号、密码
- 只是查找用的钥匙,不含任何业务信息
- 浏览器 Cookie 里实际装的就是这串字符
整体是两步跳转:浏览器出示 SessionID → 服务器拿 SessionID 翻本子查出对应那页。
只放编号不放真实信息的三个原因:
- 存不下:Cookie 4KB 容量限制装不了大件
- 改得了:浏览器端用户能改能看,敏感信息外露等于把家门钥匙挂门外
- 对不上:身份信息变时浏览器口袋老数据对不上,编号不变但指向的那页内容在变
六、登录态的维持机制
登录前:服务器已为访客开好匿名 Session 页,记录浏览痕迹,只是没「名分」。
点击登录那一刻服务器做三件事:
- 核对用户名密码
- 凭 SessionID 翻到刚才那张匿名页,在某字段写上 user_id=张三、登录时间
- 响应头附 Set-Cookie,SessionID 不变
关键洞见:登录没有创建新 Session,只是给原来的匿名页「转正」。SessionID 不变,浏览器口袋的编号不变,变的是服务器本子那一页的内容。
之后每次点任何页面:请求自动带 SessionID,服务器只问一个问题——这页上写没写 user_id?写了按已登录处理,没写视为匿名访客。登录态的本质就是服务器本子那页上有无 user_id 这一行字。
七、Session 失效的三种方式
- 超时未活动(最常见):每次操作续命,是滑动窗口(从最后一次操作算起),不是从登录算
- 用户主动退出:服务器立刻撕本子那页,同时响应头 Set-Cookie 让浏览器把 SessionID 作废;两边缺一不可
- 服务器定期清理:每隔一段时间把所有过期页面集中清掉
小王场景:登录后 4 小时无操作,30 分钟时 Session 记录已被撕;回来请求带原 SessionID 查无此页,返回「请先登录」。Cookie 文件里那串 SessionID 这一刻可能还在,但已指向已撕掉的页面。
「Cookie 被删」≠「Session 过期」
- 「Cookie 被删」≠「Session 过期」:Cookie 还在但 Session 已过期很常见。主动退出两边一起清;超时只清服务器页,浏览器 Cookie 暂时还在。
第 4 关 · Token:把「我是谁」写进凭证本身
理解 Token 这种「无状态」方案与 Session 的核心区别,能讲清何时用 Token 何时用 Session。
Token 是什么
想象一下你要去办一张港澳通行证。办完之后,证件本身就印着你的姓名、有效期、出入境签注,还有公安部门的盖章。将来每次过关时,边检人员只需要「看一眼这张卡」,就能知道你是不是本人、能不能过关、签注有没有过期——他不需要打电话去公安系统里调档案。
Token 就是互联网世界的「通行证」。
Token 是什么
**Token 是一段自包含的字符串凭证**。所谓「自包含」,意思是这张「通行证」上印全了所有需要的信息——服务器只要拿到这段字符串,看一眼就能知道:
- 你是谁(用户 ID / 身份)
- 这张通行证什么时候过期(有效期 / 过期时间)
- 这张通行证有没有被篡改过(签名 / Signature)
服务器「不需要」去翻小本本(Session 存储),「不需要」打电话去查数据库,「不需要」任何额外的查找动作——凭证本身就讲完了所有故事。
这和上一关讲的 Session 思路是**反过来**的:
- **Session 方案**:服务器发你一张只写着「编号 #3847」的卡片,服务器自己保管一本大本子,要确认你是谁必须去翻本子查编号对应的页——典型的「凭票根查表」。
- **Token 方案**:服务器发你一张「印好所有信息 + 盖章」的通行证,服务器自己什么都不存,要确认你是谁只要看一眼通行证本身——典型的「看证件即可」。
JWT:Token 最主流的实现形式
听起来很神奇:凭证印在客户端(浏览器 / App)那边,服务器凭什么相信它没被伪造?答案是**签名**。签名是服务器用一把「私钥」对通行证内容算出的「防伪码」,任何对内容的篡改都会让签名校验失败。
目前最主流的 Token 实现形式叫 **JWT(JSON Web Token,读作「jot」)**。它的结构像一份「分段式通行证」,由三段用英文句点 `.` 分隔的字符串拼起来:
eyJhbGciOiJIUzI1NiJ9.eyJ1c2VyX2lkIjoxMjM0LCJleHAiOjE3MDAwMDAwMDB9.kF3...签名部分
flowchart LR
    A[第一段 头部] -->|声明算法类型| C[完整 JWT 字符串]
    B[第二段 载荷] -->|携带用户身份和有效期| C
    D[第三段 签名] -->|防伪盖章| C
    C --> E[服务器 收到后只看这三段]
    E --> F[验签通过 直接信任]
- **第一段(Header)**:声明「这份通行证用的什么防伪算法」,比如 HMAC-SHA256。
- **第二段(Payload)**:真正携带信息的部分——用户 ID 是 1234、过期时间是某个时刻、还可以塞一些角色权限之类的字段。
- **第三段(Signature)**:服务器用私钥对前两段内容算出的「盖章」。服务器收到 JWT 时,重新算一遍签名,如果和你交上来的对得上,就证明「内容没被改过 + 确实是本系统签发的」。
一个具体场景
你在某 App 登录成功后,服务器返回一段 JWT 给你(通常通过响应体或写入 Cookie/Storage)。之后你访问任何接口都自动附带这段字符串。服务器三步搞定:
- 拆开 JWT 拿到三段内容
- 用同一把私钥重算签名
- 签名对得上、没过有效期 → 放行;否则拒绝
整个过程**没有查数据库**、**没有翻小本本**,服务器完全是「无状态」的——它不需要记住任何人的登录状态,因为状态全写进了通行证本身。
至于为什么这套方案在很多产品里越来越常见、它和 Cookie / Session 之间到底是什么关系——本模块后面会继续拆解。
**要点:**Token 是一段自包含字符串,自身就携带用户身份、有效期、签名,服务器只要「看证件」就能完成身份验证,**不需要查小本本**;JWT 是目前最主流的 Token 实现形式,由「头部 + 载荷 + 签名」三段组成。
Token 与 Cookie 的关系
上一节我们说,Token 是一段自包含的字符串——上面印着用户身份、有效期、签名,服务器只要「看证件」就能验明正身。
但这里有个很自然的问题:这张「证件」从服务器发到浏览器之后,**放哪?**每次访问新页面时,又**怎么再送回给服务器**?
这一节我们就把「凭证」和「凭证的载体」分开来讲。
一个生活类比:情书和信封
想象一封情书(你把它想成 Token 这段字符串)——它**本身是有内容的**,有称呼、有正文、有落款。
但这封信你要交给对方,得有个**载体**。你可以:
- 装进牛皮纸信封,走邮政平信
- 塞进一个布袋,托顺丰小哥
- 拍照发微信
- 让对方来你家当面拿走
载体可以换,但**情书的内容不会因为换载体就变了**。
Token 和 Cookie 的关系,就是这样:**Token 是「内容」,Cookie 是「载体」之一**。两者不是绑死的关系。
Cookie:最省事的载体
Cookie 可以理解成浏览器**专门给网站腾出来的小储物格**。当你登录成功后,服务器可以在响应里用 `Set-Cookie` 指令把 Token 塞进这个小格子里。
神奇的地方在于:**之后你访问这个网站的任何一个页面,浏览器都会自动帮你把 Cookie 里的内容带上去**,完全不用你或前端代码操心。
这就是为什么 Cookie 成了最常见的载体——浏览器自动帮你带,开发者完全不用动手。
localStorage:另一个口袋
但 Cookie 不是唯一的口袋。浏览器的 `localStorage`(本地存储)也是一块空间,前端 JS 可以手动把 Token 写进去,每次发请求时**手动**从 localStorage 里读出来,塞到 HTTP 请求头里的 `Authorization` 字段上送给服务器。
flowchart TD
    A[服务器签发 Token 字符串] --> B{前端选择放哪}
    B -->|Cookie| C[浏览器自动管理<br>每次请求自动带上]
    B -->|localStorage| D[JS 主动存取<br>手动塞到请求头]
    B -->|SessionStorage| E[关闭标签页就清空]
    C --> F[请求送到服务器]
    D --> F
    E --> F
    F --> G[服务器看 Token 验签]
这三种方式,**Token 都是同一段字符串**,只是被放在不同的「口袋」里、通过不同的路径送到服务器而已。
为什么不绑死
为什么要强调「不是绑死」?因为产品里**经常需要换载体**:
- 你做一个**移动端 App**,没有浏览器的 Cookie 机制,自然就不能用 Cookie 装 Token,得自己存到手机本地(类似 localStorage 的角色),然后每次发请求手动带上。
- 你做一个**第三方开放接口**(比如允许别家公司来调用你的数据),他们根本没有你的域名 Cookie,必须让他们把 Token 放在 `Authorization` 头里带过来。
- 你做一个**跨域前后端分离**的项目,前端在 `a.com`、后端在 `api.a.com`,浏览器对跨域 Cookie 限制很严(这正是下两节要讲的「同源与跨域」),很多人干脆放弃 Cookie,改把 Token 放 localStorage 或请求头里。
所以在产品设计里,「**用 Token 还是用 Session**」和「**用 Cookie 装还是用其他方式装**」其实是**两个独立的问题**——经常被混在一起说,但其实可以拆开看。
**要点:**Token 是「凭证内容」,Cookie 只是「凭证的常见载体」之一;Token 也能放 localStorage 或塞到请求头里,**两者不是绑死关系**,产品里可以按场景自由组合。
有状态 vs 无状态:验票 vs 看证件
上一节我们看到,Token 这段字符串里**已经自带了所有信息**——谁、有效到什么时候、签名是什么。
这一节我们就来对比一下这种新思路和 Session 老思路的**根本差别**——这个差别有个很专业的名字,叫「**有状态**」和「**无状态**」。
一个生活类比:电影票 vs 工作证
想象两种完全不同的入场方式:
**方式一:电影院的电影票** 你买票时拿到一张小票根,票根上只印着「第几排第几座」。但**真正的分配信息其实在影院的小本本上**——工作人员把你那张票根和你对应的座位号、票价记在系统里。 进场时,工作人员拿你票根去系统里**查一下**——「哦,3 排 7 座」——然后放你进去。 ——**问题来了**:如果影院系统宕机,或者工作人员找不到那个本本,你的票根就成了一张废纸,进不了场。
**方式二:公司工作证** 工作证上**直接印着**你的名字、照片、部门、有效期。保安**看一眼证件本身**,核对照片对不对、有没有过期、印章真不真——就能直接放你进去。 ——**关键区别**:保安不需要去翻本本,**证件自带了所有信息**。
flowchart LR
    subgraph 方式一_电影票
    A1[用户出示票根] --> A2[工作人员查本本]
    A2 --> A3[本本里有分配记录]
    A3 --> A4[查到座位放行]
    end
    subgraph 方式二_工作证
    B1[用户出示证件] --> B2[保安看证件本身]
    B2 --> B3[核对印章和有效期]
    B3 --> B4[放行]
    end
回到登录态:到底什么叫「状态」
放在登录这个场景里,「**状态**」这个词其实就在问一件事:
> 服务器**除了你这次请求本身**以外,**额外**为你在内存或数据库里**留了什么东西**没?
- **Session 方案(有状态)**:服务器会给每个登录用户**开一条临时记录**(什么 user_id、登录时间、最近活跃 IP 等等),存在它的小本本里——可能叫 Redis,可能叫数据库。Cookie 里那串 `session_id` 只是个**编号**,是去查本本的「索引」。
- **Token 方案(无状态)**:服务器**不为任何用户开临时记录**。它就只做一件事——**看一眼 Token 上印的信息**(用户 id、有效期),再**验一下签名**(确认这 Token 不是伪造的)——通过就放行。本本在哪?**没有本本**。
一个具体例子:10 万人同时在线
假设你的网站有 **10 万人同时在线**。
**如果用 Session(有状态)**: 服务器内存或 Redis 里要一直挂着 10 万条会话记录。每来一个请求,服务器都要**查一下**——这一条是不是有效?有没有过期?对应的是哪个用户?哪怕查得再快,**10 万条就是 10 万次查询**。更麻烦的是:你再加一台服务器做负载均衡,新服务器上**没有这些记录**,得先把会话同步过去,否则用户就被「踢下线」了。
**如果用 Token(无状态)**: 服务器里**根本没有这 10 万条记录**。每个请求来,服务器就只做「验签 + 看有效期」这一个动作——**管你是 10 万人还是 1000 万人在线,活儿都是一样的**。再加一台服务器?新机器什么状态都不用迁,因为本来就没状态。
这就是为什么做**大流量、跨服务、分布式**的系统时,工程师会优先选 Token——**加机器就能扩容**,不用把用户的状态同步到每一台机器上。
一点容易误解的
「无状态」不是「服务器什么都不记」——服务器还是要记**用户基本信息表**的(用户名、密码、权限这些)。它**不记的是**:「当前这一刻,谁的会话是开的、活不活」这种**临时**的状态。
**要点:**Session 是「有状态」——服务器靠「小本本 + 票根编号」识别你;Token 是「无状态」——服务器不存会话,**只验凭证本身**。无状态让服务器不用为每个在线用户维持临时记录,**更轻、更易横向扩展**。
何时选哪种方案
一个落地的问题:那我到底用哪个?
前三块我们把 Token 是什么、它和 Cookie 的关系、它和 Session 的本质区别都讲清楚了。但你作为产品/业务方,落到真实项目里,**第一个要拍板的问题**其实是——
> 这个产品,到底该用 Session,还是该用 Token?
这一节我们就按**真实的产品场景**,把选型背后的逻辑讲透。
决策的关键不是「技术新不新」,是「场景长什么样」
工程师圈子里有种误解:「Token 比 Session 高级,所以新项目都应该用 Token。」这话**对了一半**。Token 在某些场景下确实更顺手,但 Session 在另一些场景下反而更省心。**选型的真正依据是产品场景本身**——具体说,就是以下几个问题:
- 这个产品是**只在浏览器里跑**,还是要做成**手机 App**?
- 是不是会有**跨域调用**(一个前端要去敲多个不同域名下的接口)?
- 是不是要把**能力开放给第三方**调用?
- 后端是**一个服务**扛所有活,还是**一堆微服务**分工合作?
flowchart TD
    A[开始选型] --> B{产品形态是什么?}
    B -->|传统 Web 网站| C[Session 加 Cookie]
    B -->|手机原生 App| D[Token]
    B -->|前后端分离 SPA| E[看是否跨域]
    E -->|同域| C
    E -->|跨域| D
    B -->|开放给第三方| F[Token 通常是 API Key 或 OAuth]
    B -->|多微服务协作| D
    C --> G[浏览器自动带 Cookie<br>后端共享一份 Session 存储]
    D --> H[每次请求手动带 Token<br>后端无状态,各服务各自验签]
场景一:传统网站 → Session + Cookie
如果你做的是**只在浏览器里跑的传统网站**(公司内部 OA、论坛、电商后台、内容管理后台……),Session + Cookie 几乎**永远是更省事的方案**。原因有三:
- **浏览器天然帮你管理 Cookie**:用户登录后,浏览器每次请求都会**自动把 Cookie 附上**,前端代码完全不用操心「这次请求带没带凭证」。
- **同一个域名的请求场景,Session 存一次就能用**:因为所有页面都在 `www.example.com` 下,服务器用 Redis 存一份会话数据,**所有页面都查得到**。
- **注销很方便**:用户点「退出登录」,服务器**直接删掉那条 Session 记录**就行——Cookie 立刻失效。这叫「**主动吊销**」,Session 做起来毫不费力。
**具体例子**:你做一个公司内部报销系统,员工登录后能在 5 个页面之间来回切。每个页面都是同一个域名的普通网页,浏览器自动带 Cookie,后端用一份 Redis 存所有员工的登录态。**最简单、最稳、最不容易出岔子。**
场景二:手机 App → Token
如果你做的是**手机原生 App**(iOS Swift、安卓 Kotlin 写的、不是网页壳套的那种),情况就完全反过来了:
- **App 没有「浏览器自动管理 Cookie」这回事**。App 发起的网络请求得**自己**在代码里写清楚「这次请求要带什么凭证」——这种场景下,Token(一个字符串塞到 HTTP Header 里)**写起来比 Cookie 直观得多**。
- 手机 App 经常要同时调**好几个后端服务**(登录服务、订单服务、支付服务……),每个服务**单独验证 Token 就行**,不用共享 Session 存储。
- App 跨网络环境(4G/WiFi 切换、弱网重连)很频繁,**无状态**的 Token 抗折腾能力更强——服务端不会因为网络切换而「以为你下线了」。
**具体例子**:你的手机银行 App,启动后 5 分钟内可能要调 20 个不同的接口(查余额、查账单、转账……),每个接口都来自不同的微服务。Token 方案下,App 内存里就放着那一串 Token,每次发请求带着,**每个微服务各自验签、各自放行**——不用为「怎么让 20 个服务都认识这个用户」这件事操心。
场景三:跨域调用、开放平台 → 几乎只能用 Token
- **跨域**:Cookie 有**同源策略**这道墙(上一关我们讲过),浏览器**默认不允许** `a.com` 的页面拿到 `b.com` 设的 Cookie。如果你的前端在 `a.com` 但接口在 `api.b.com`,用 Cookie 会非常折腾。Token 不受这个限制——它就是个 HTTP Header,**哪个域都能带**。
- **开放平台 / 第三方调用**:你把能力开放给别人的公司调用,**第三方服务器上不可能有你的 Session 存储**。你只能给他们发一个 Token(或 API Key),他们每次请求自己带上来。
**具体例子**:微信开放平台把「发消息」「获取用户信息」这些能力开放给第三方 App,第三方拿到的是一个 **access_token**,不是 Cookie——因为微信不可能去第三方服务器上存 Session。
一句话总结选型逻辑
> **产品只在一个域名的浏览器里跑** → Session + Cookie 最省事; > **有原生 App、跨域、第三方、微服务任意一个** → Token 更顺手。
**要点:**选 Session 还是 Token,**不靠技术新旧,靠场景**——传统 Web 站 Session + Cookie 够用且省心;一旦涉及原生 App、跨域、第三方调用、微服务中任意一种,无状态的 Token 几乎就是更合理的选择。
学习笔记
Token 学习笔记
Token 的核心:自包含凭证
Token 是一段**自包含**的字符串凭证——服务器只要拿到这段字符串,就能直接知道:
- 用户身份(用户 ID)
- 凭证有效期(过期时间)
- 是否被篡改(签名)
服务器**不需要**查 Session 存储、**不需要**查数据库、**不需要**任何额外查找动作。
Token vs Session 思路对比
- **Session 方案**:服务器发一张只写编号的卡片,自己保管一本记录本,验身份必须去翻本子查编号(凭票根查表)
- **Token 方案**:服务器发一张印好所有信息 + 盖章的通行证,自己什么都不存,验身份只要看证件本身(看证件即可)
JWT:Token 最主流的实现形式
JWT(JSON Web Token,读作「jot」)由三段用英文句点 `.` 分隔的字符串拼成:
- **第一段 Header**:声明防伪算法类型,如 HMAC-SHA256
- **第二段 Payload**:携带用户 ID、过期时间、角色权限等真实信息
- **第三段 Signature**:服务器用私钥对前两段内容算出的「防伪盖章」
服务器验签流程:拆开 JWT → 用同一把私钥重算签名 → 签名对得上 + 未过期 = 放行;否则拒绝。整个过程**不查数据库、不翻存储**,服务器完全无状态。
Token 与 Cookie:内容 vs 载体
Token 是「**内容**」(一段凭证字符串),Cookie 是「**载体之一**」——两者不是绑死的关系。
常见存放方式
- **Cookie**:服务器用 `Set-Cookie` 把 Token 塞进浏览器,浏览器每次请求**自动**带上
- **localStorage**:前端 JS 手动存取,发请求时手动塞到 `Authorization` 头
- **SessionStorage**:关闭标签页就清空
这三种方式里 Token 都是同一段字符串,只是放在不同口袋、通过不同路径送达。
为什么不能绑死
- 移动端 App 没有浏览器 Cookie 机制,必须自己存 Token
- 第三方开放接口,对方没有你的域名 Cookie,必须用 `Authorization` 头带 Token
- 跨域前后端分离,浏览器对跨域 Cookie 限制严格,常放弃 Cookie 改用 localStorage 或请求头
**关键认知**:「用 Token 还是用 Session」和「用 Cookie 装还是用其他方式装」是**两个独立的问题**,可以拆开决策。
有状态 vs 无状态
「状态」问的是:服务器**除了这次请求本身**以外,有没有为用户在内存或数据库里**额外留了东西**?
- **Session 方案(有状态)**:服务器为每个登录用户开一条临时记录,Cookie 里的 `session_id` 只是查本本的索引
- **Token 方案(无状态)**:服务器不为任何用户开临时记录,只验签 + 看有效期,没有本本
10 万人同时在线的对比
- **Session**:服务器挂着 10 万条会话记录,每个请求都要查一次;加机器扩容得先同步会话,用户否则被踢下线
- **Token**:服务器没有这些记录,每个请求只做验签 + 看有效期,10 万人和 1000 万人干的活一样;加机器不用迁任何状态
这是大流量、分布式系统优先选 Token 的原因:**加机器就能扩容**。
> 注意:「无状态」不是「服务器什么都不记」——用户基本信息表(用户名、密码等)还是要存的。
选型决策:看场景,不看新旧
选型依据是**产品场景本身**,不是「技术新不新」。需要回答四个问题:
- 产品只在浏览器跑,还是要做手机 App?
- 有没有跨域调用?
- 要不要开放给第三方?
- 后端是单体还是多微服务?
典型场景
- **传统 Web 网站(同域)→ Session + Cookie**:浏览器自动带 Cookie,服务器用 Redis 存一份会话,所有页面都查得到;注销时直接删 Session 记录即可(主动吊销很方便)
- **手机原生 App → Token**:App 没有浏览器自动管理 Cookie,Token 塞到 HTTP Header 更直观;多后端服务各自验签
- **开放给第三方 → Token / API Key / OAuth**:对方没有你的域名 Cookie
- **多微服务协作 → Token**:各服务各自验签,无状态便于扩容
第 5 关 · 同源策略:Cookie 跨域的边界
理解同源策略三要素以及 Cookie 的同源边界,能讲清为什么 a.com 的登录态不会泄露到 b.com。
同源策略三要素
想象一下:你手里有一张「淘宝会员卡」,但你拿着这张卡去「京东」的收银台结账——收银员一定不会认。为什么会这样?因为会员卡背后绑定了一整套「身份体系」:发卡方、卡号、有效期……每张卡只在它自己那套体系里有效。
浏览器里的 Cookie 就像这张会员卡。但「它自己那套体系」具体由什么决定?这就要讲今天的主角——**同源策略**(Same-Origin Policy)。
同源:浏览器判断「是不是同一家人」
浏览器每次要决定「这个 Cookie 能不能用、这段 JS 能不能读那个页面的数据」,都要先做一个判断:当前页面和目标页面,是不是「**同源**」?
浏览器把 URL 拆成三个零件,只有这三样**完全一致**,才认定是同源:
| 要素 | 含义 | 常见取值 | |------|------|----------| | **协议** | 通信方式 | `http://` 或 `https://` | | **域名** | 网站名字 | `taobao.com`、`baidu.com` | | **端口** | 通信的「门牌号」 | `:80`、`:443`、`:8080` |
**三要素必须完全相同**——少一个不同,浏览器就判「跨域」,Cookie 默认就不会自动送过去。
flowchart TD
    Start[浏览器判断: 这两个页面同源吗?] --> P{协议相同?}
    P -->|否| Cross[跨域<br/>Cookie 不自动发送<br/>数据相互隔离]
    P -->|是| D{域名相同?}
    D -->|否| Cross
    D -->|是| Port{端口相同?}
    Port -->|否| Cross
    Port -->|是| Same[同源<br/>Cookie 正常附带<br/>资源共享]
三个例子看清边界
- **协议不同 → 跨域**:`https://www.taobao.com` 和 `http://www.taobao.com`,https 比 http 多一道「安全锁」,浏览器认为这是两家人。
- **域名不同 → 跨域**:`https://www.taobao.com` 和 `https://www.jd.com`,明显两家网站,互不认识。
- **端口不同 → 跨域**:`https://www.taobao.com:443` 和 `https://www.taobao.com:8080`,端口就像公司前台的不同分机号,分机不同,对接的部门可能就不一样。
很多人会忽略**端口**——平时大家写网址几乎不写端口(因为 80 和 443 是默认的)。但浏览器在判断时是死板地逐项对照的:哪怕只差一个端口号,它都「翻脸不认人」。
为什么同源策略是「最基本的安全边界」
登录态(也就是你 Cookie 里那串身份信息)其实是一把钥匙——能开你家那扇门。
如果没有同源策略,你访问 `a.com` 时浏览器口袋里那张写着「淘宝已登录」的纸条,就会被 `b.com` 偷偷拿走去用——相当于你去便利店刷卡,门卫把你的卡抄了一份寄给了隔壁银行,银行也能拿你的卡取钱。
同源策略就是浏览器在每个网站之间拉起的一道「隔离网」:`a.com` 的钥匙送不到 `b.com`,`b.com` 想读 `a.com` 的数据也被挡在门外。这道闸门规则不复杂(三要素比对就完事),但它撑住了浏览器安全的第一道防线——后面所有 Cookie 的归属、跨域限制、登录态隔离,全都建立在它之上。
**要点:** 同源 = 协议 + 域名 + 端口三者**完全相同**,只要有一项不同,浏览器就判跨域——这是浏览器把所有网站隔离开的「第一道闸门」,也是登录态不会被乱用的根本前提。
Cookie 的同源边界
Cookie 的同源边界:钥匙默认只能开自己那扇门
上一节我们讲了,浏览器用「协议 + 域名 + 端口」三要素判断两个页面是不是同源。但 Cookie 自己还有一套更细的规则——**就算两个页面「同源」,Cookie 也不一定就会自动送过去**。这把钥匙的「有效范围」,由 Cookie 自己的两个属性说了算:**Domain** 和 **Path**。
默认:钥匙只发给「配对的那扇门」
想象小区门禁卡:你办了小区 A 的门禁卡,默认只能刷 A 的大门。隔壁小区 B 哪怕和 A 是同一个开发商、同一批物业,你的卡也刷不开——因为卡里只记录了「A 小区」这个范围。
Cookie 的默认行为就是这样:**当服务器通过 Set-Cookie 把一个 Cookie「种」到 a.example.com 时,这个 Cookie 默认只会在你访问 a.example.com 时被浏览器自动带上**。你去 b.example.com(同一个父域,但不同的子域),浏览器不会主动送过去。
为什么要这样默认?浏览器在替你把关:万一 a.example.com 上的某段脚本有恶意,它就不至于把整个家族(example.com)的身份信息都泄漏出去。**「默认最小授权」,是浏览器对身份信息最谨慎的态度**。
Domain 属性:把钥匙「授权」给整个家族
但很多公司希望子域之间能共享登录态。比如你在 `taobao.com` 登录了,去 `juhuasuan.taobao.com`(聚划算)也不想再登录一次。这时候,服务器在 Set-Cookie 时必须**显式声明 Domain 属性**:
Set-Cookie: session=abc123; Domain=.example.com; Path=/
这个「`.example.com`」开头的点(leading dot)就像在告诉浏览器:「这把钥匙,我授权给 example.com 旗下的所有子域都能用。」一旦这样设置,浏览器在访问 a.example.com、b.example.com、c.example.com 时,都会自动带上这个 Cookie——因为它们都「认」example.com 这个大家长。
这里有两个细节值得记一下:
- **Domain 只能往「更大的范围」设**。你在 a.example.com 上种的 Cookie,不能把 Domain 写成 b.example.com 去「定向发给 b」——这种写法浏览器不认,默认还是按你种下时那个精确域来处理。
- **必须显式声明才共享**。不写 Domain 属性,就意味着「我自己一家用」。
Path 属性:门牌号级别的限制
Domain 决定「能进哪个小区」,Path 决定「能进小区的哪几层」。
Path 默认是「种下 Cookie 那个页面的路径」。比如你在 `example.com/users/profile` 下种了一个 Cookie,Path 默认就是 `/users/`——这个 Cookie 在 `example.com/users/settings` 下会被自动带上,但在 `example.com/products/123` 下就不会被带上(因为 `/products/` 不在 `/users/` 之下)。
实际产品中,Path 通常都设成 `/`(根路径),意思是「整站都生效」。但你要知道它存在——它给了服务器一个比 Domain 更细的「路线控制权」。
一个完整流程图
flowchart TD
    Server[服务器种 Cookie 时<br/>Set-Cookie: Domain=.example.com<br/>Path=/] --> Store[浏览器存下 Cookie<br/>标注: 适用所有 example.com 子域]
    Store --> V1[访问 a.example.com]
    Store --> V2[访问 b.example.com]
    Store --> V3[访问 example.com 首页]
    V1 --> S1[自动带上 Cookie ✓]
    V2 --> S2[自动带上 Cookie ✓]
    V3 --> S3[自动带上 Cookie ✓]
    Store -.未设 Domain.-> X[默认只发给精确域 a.example.com<br/>b.example.com 收不到]
只要服务器在种 Cookie 时说了「Domain=.example.com」,example.com 旗下所有子域的用户都会自动保持登录态——这正是「一次登录,全站通用」背后那个不起眼但关键的小开关。
为什么这套设计很合理
回到上一节的安全视角:Cookie 之所以默认只发给「精确的那个域」,是为了**避免任何一个子域能偷窥或借用其他子域的登录态**。当公司真的需要跨子域共享时,它必须**显式声明**(Domain=.example.com)——这一「显式授权」让责任清晰:是你主动选择共享的,那相应的风险也由你承担。
把上节和本节拼起来看:
- **同源策略**是浏览器在「跨域之间」拉的隔离网(防止 a.com 偷 b.com 的数据);
- **Domain 属性**是 Cookie 在「同父域不同子域之间」的默认隔离(防止 a.example.com 偷 b.example.com 的登录态)。
两道闸门,一道看「协议+域名+端口」,一道看「Cookie 自己声明的覆盖范围」——共同构成了登录态不乱串的底层规则。
**要点:** Cookie 的覆盖范围由 Domain(决定哪些子域能收到)和 Path(决定哪些路径能收到)两个属性控制;默认只发给「精确配对」的那个域,要让子域共享必须服务器显式设 `Domain=.example.com`。
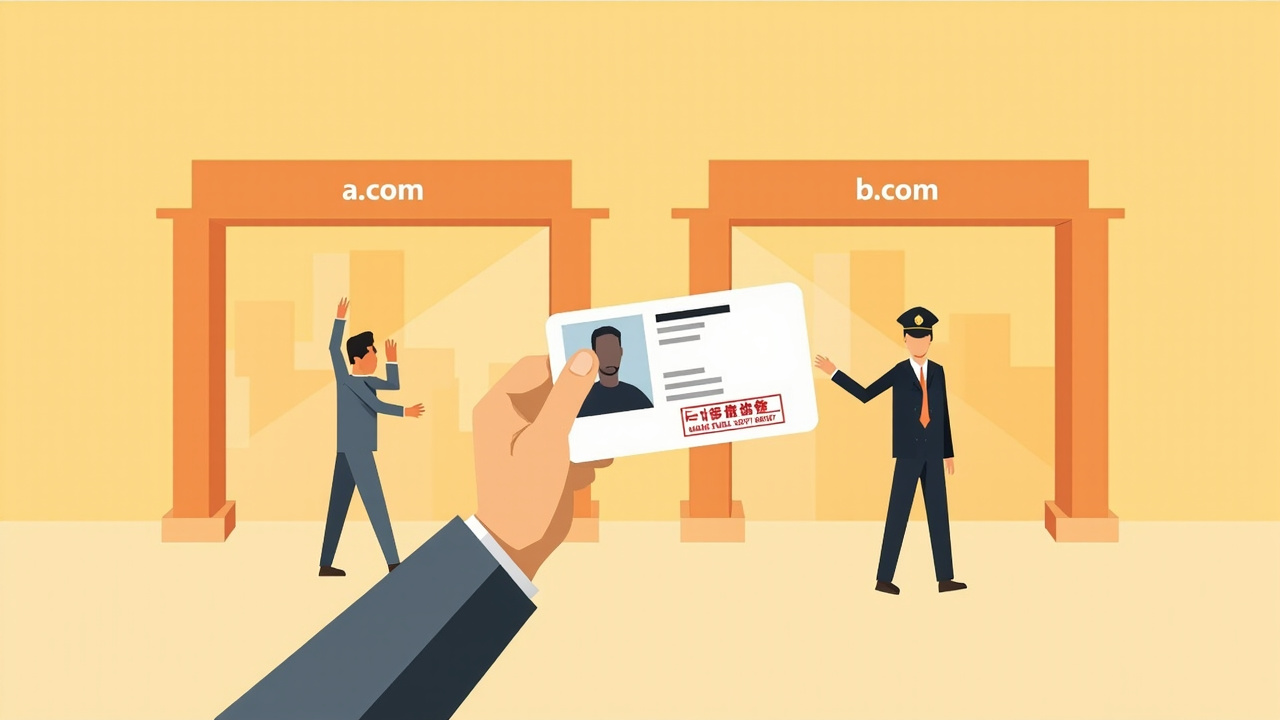
跨域直觉:身份证只在本市有效
跨域直觉:身份证只在本市有效
身份证的「地盘」
想象你拿着一张居民身份证去办事。身份证背面印着「仅限本市使用」——你到本市任何一个政府机关、医院、银行,都能用它证明身份。但是一旦你出了这个市、跨省了,这张身份证就「不算数」了:对方不会认,机场边检会要求你重新出示有效证件(护照、临时身份证明等)。
为什么身份证要这么设计?因为**一张身份证明如果在哪儿都通用,万一丢了或者被偷了,后果不堪设想**——骗子拿着它能在全国任何地方冒充你。所以身份证的设计哲学是:**默认最小授权**,只在最需要的地方有效。
把这个直觉搬到浏览器
Cookie 在浏览器里的命运,跟这张「限本市使用」的身份证几乎一模一样。回想上一节讲的:服务器通过 Set-Cookie 把 session=abc123 种到 a.com 时,浏览器会把这个 Cookie **贴上「a.com 专用」的标签**。以后你访问 b.com,浏览器看到 Cookie 上面写着「a.com 专用」,就**不会**主动把它发出去;就算发出去,b.com 服务器收到了,也无法在自己的 JavaScript 里读取它。
更关键的是,**a.com 上的 JavaScript 代码**——哪怕页面里嵌了第三方广告、统计脚本、推荐 widget——**它们统统都没有权限去读 b.com 的 Cookie**。这就是上一节同源策略在执行:协议+域名+端口任一不同,a.com 那侧的脚本就被浏览器「挡在门外」,读取操作直接拒绝。
一道闸门的全貌
flowchart TD
    User[你在 a.com 上浏览] --> JS[a.com 页面的脚本试图读 b.com 的 Cookie]
    JS --> Browser{浏览器检查同源}
    Browser -->|不同源 a 不等于 b| Block[拒绝读取<br/>直接报错]
    Browser -->|同源才放行| Allow[允许读取]
    Block --> Safe[登录态安全]
    Allow --> Normal[同源内正常协作]
为什么登录态必须这样被管着
如果浏览器没这道闸,会发生什么?想象你正开着 a.com 看新闻,同时另一个标签页开着 b.com。b.com 上有一段恶意代码(可能是某次广告位被攻击植入的),它想「借」你的 a.com 登录态去伪造交易——比如把你的购物车「寄」到攻击者的地址。
如果没有同源策略,b.com 的脚本可以**直接调用 a.com 的接口、读 a.com 的 Cookie**,你的登录态完全暴露。有了同源策略,b.com 那侧的脚本**连 a.com 的 Cookie 的影子都看不到**——它发出的跨域请求会先被浏览器拦下,到了服务器也会被服务器拒收。
这就是「闸门」的意义
把上两节连起来看一道完整的安全机制:
- **同源策略三要素**(协议+域名+端口)画出了「什么算同源」的判定线;
- **Cookie 的 Domain/Path 属性**画出了「即使同源,Cookie 默认也只在小圈子里流动」的范围线;
- 两者合起来,给你的登录态套上了**两层默认的最小授权**:不到必要时刻,绝不主动跨域。
所以「身份证只在本市有效」这个类比,不只是个形象说法——它准确描述了浏览器在做的事:**默认不信任,必要时才显式授权**。这正是它能「替你挡掉一大半不必要的身份泄漏」的关键原因。
**要点:** 跨域时浏览器拒绝 a.com 的脚本读 b.com 的 Cookie——这是把登录态「锁在它自己的市里」,避免任何跨域偷用;同源策略就是浏览器保护用户登录态的那道闸门,默认不信任、显式授权才放行。
学习笔记
一、同源策略:什么是「同一家人」
判定三要素
浏览器每次判断「两个页面是不是同源」,都把 URL 拆成三个零件,三者**完全一致**才算同源:
| 要素 | 含义 | 常见取值 | |------|------|----------| | 协议 | 通信方式 | `http://`、`https://` | | 域名 | 网站名字 | `taobao.com` 等 | | 端口 | 通信的「门牌号」 | `:80`、`:443`、`:8080` |
**任一项不同 → 跨域**。浏览器对每项都死板逐项对照;端口最容易被忽略(因为 80、443 是默认端口,平时不写出来),但差一个端口号也照样判跨域。
跨域三例
- **协议不同**:`https://www.taobao.com` 与 `http://www.taobao.com` → 跨域
- **域名不同**:`https://www.taobao.com` 与 `https://www.jd.com` → 跨域
- **端口不同**:`https://www.taobao.com:443` 与 `https://www.taobao.com:8080` → 跨域
为什么是「第一道闸门」
登录态(Cookie 里的身份信息)就是一把钥匙。同源策略是浏览器在每个网站之间拉起的「隔离网」——`a.com` 的钥匙送不到 `b.com`,`b.com` 也读不到 `a.com` 的数据。这道规则简单(三要素比对),但撑住了浏览器安全的第一道防线。
---
二、Cookie 的同源边界:Domain 与 Path
页面「同源」≠ Cookie 一定会被自动带上。Cookie 自己还有两个属性决定它的有效范围:**Domain** 和 **Path**。
默认行为:只发给「配对的那扇门」
服务器通过 `Set-Cookie` 把 Cookie 种到 `a.example.com` 时,默认**只在该子域**被自动带上。同父域的其他子域(如 `b.example.com`)不会收到。这体现的是**「默认最小授权」**——浏览器对身份信息最谨慎的态度。
Domain 属性
服务器可显式声明 `Domain` 把 Cookie 授权给整个家族共享:
Set-Cookie: session=abc123; Domain=.example.com; Path=/
带前导点的 `.example.com` 表示该 Cookie 在 `a.example.com`、`b.example.com`、`c.example.com` 等所有子域都会被自动带上。
两个细节:
- **Domain 只能往更大的范围设**;不能「定向发给」别的子域(在 `a.example.com` 上把 Domain 写成 `b.example.com`,浏览器不认)。
- **不显式写 Domain** = 默认「自己一家用」,不跨子域共享。
Path 属性
- Path 默认是「种下 Cookie 那个页面的路径」。
- 例:在 `example.com/users/profile` 种的 Cookie,Path 默认 `/users/`,则 `example.com/users/settings` 会被带上,但 `example.com/products/123` 不会。
- 实际产品中通常设成 `/`(整站生效),但要清楚它存在——给了服务器比 Domain 更细的「路线控制权」。
---
三、跨域直觉:身份证只在本市有效
身份证背面印着「仅限本市使用」
身份证背面印着「仅限本市使用」——本市任何机关通用,跨省就「不算数」。背后是**默认最小授权**的设计哲学:一张身份证明如果哪儿都通用,丢了后果不堪设想。
套到浏览器
Cookie 在浏览器里的命运与此一致:
- 服务器把 `session=abc123` 种到 `a.com`,浏览器给它贴上「`a.com` 专用」标签。
- 访问 `b.com` 时,浏览器**不会**主动把这个 Cookie 发出去;就算发出去,`b.com` 自己的 JS 也**读不到**它。
- `a.com` 上的 JS(即使嵌了第三方广告、统计、推荐 widget)也没有权限读 `b.com` 的 Cookie——同源策略直接拒绝。
反面推演:没有同源策略会怎样
- 你开 `a.com` 看新闻,另开 `b.com`;`b.com` 里有被攻击植入的恶意代码。
- 若没同源策略,`b.com` 脚本可直接调 `a.com` 接口、读 `a.com` Cookie,登录态完全暴露。
- 有了同源策略,跨域请求先被浏览器拦下,服务器也会拒收。
两层「默认最小授权」
把两条线合起来看:
- **同源策略三要素**画「什么算同源」的判定线;
- **Cookie 的 Domain/Path** 画「即使同源也只在小圈子流动」的范围线。
两层叠加,登录态在「不到必要时刻、绝不主动跨域」的规则下被牢牢锁住。
**要点:** 跨域时浏览器拒绝 `a.com` 的脚本读 `b.com` 的 Cookie——同源策略就是保护用户登录态的那道闸门:默认不信任,显式授权才放行。
第 6 关 · 完整登录流程:把前面所有概念走一遍
能完整讲出一次登录→浏览→下单→退出的全过程,把 Cookie、Session、Token、同源边界都串起来。
完整流程串讲(Cookie + Session 版)
一张图走完全程
还记得「卡片只写编号、书单全在管理员本子里」这个比喻吗?现在我们把这个比喻放进一次真实的购物流程里走一遍,看看从打开首页到退出登录,Cookie 和 Session 是怎么接力的。
第 1 步:打开首页(未登录)
小明第一次打开淘宝首页。
- 浏览器发 HTTP 请求到 taobao.com
- 服务器发现这是新访客(没有任何纸条跟过来),于是做两件事:
- 在小本本上撕下一页新纸,写上「匿名访客 #3847」,记下创建时间
- 在响应里塞一条 `Set-Cookie: session_id=3847`
- 浏览器收到响应,把 3847 这条小纸条存进「淘宝」专属口袋
- 服务器返回首页 HTML(顶栏显示「请登录」)
第 2 步:登录(核心节点)
小明输入用户名密码,点登录。
- 浏览器把用户名密码 + 小纸条 3847 一起发给服务器
- 服务器做两件事:
- **验证身份**:去数据库里查用户名密码是否对得上
- **更新小本本**:翻到 3847 这一页,把「姓名」一栏从「匿名访客」改成「用户ID=小明」,并记下登录时间
- 服务器返回「登录成功」
- 浏览器口袋里那张纸条**还是 3847**——号码没变,但意义已经从「匿名」变成「小明」
**关键理解**:登录这个动作没有换一张新纸条,只是让管理员在小本本上那一页的「姓名栏」改了字。
第 3 步:跳到商品页
小明点开一个商品详情。
- 浏览器自动从小纸条口袋里取出 3847,跟着请求一起发过去
- 服务器拿到 3847,去小本本翻到 3847 这一页
- 看到「姓名栏 = 小明」→ 这是已登录用户
- 返回商品详情页(顶栏显示「你好,小明」)
第 4 步:加入购物车
小明点「加入购物车」。
- 浏览器还是带 3847 去
- 服务器翻到 3847 这一页
- 在「购物车」那一栏写下「商品A × 1,¥99」
- 返回「加入成功」
**关键理解**:购物车里的商品**既没有存在浏览器本地,也没有存在 Cookie 里**——它存在服务器小本本上 3847 这一页。Cookie 那张纸条从头到尾只写了一个编号,真正的商品数据是服务器自己保管的。
第 5 步:结账
小明点「去结算」。
- 浏览器带 3847 去
- 服务器翻 3847 这一页:是小明本人 + 购物车有商品
- 生成订单(订单会写进数据库,那属于更长期的「账本」,跟 Session 不是一回事)
- 扣款、清空购物车那一栏、返回支付成功页
第 6 步:退出登录
小明点「退出」。
- 浏览器带 3847 去
- 服务器翻到 3847 这一页,把「姓名栏」改回空,或者直接把这页撕掉(删除 Session)
- 同时让浏览器把那张 3847 纸条扔掉(设置 Cookie 过期)
- 返回首页(顶栏又变回「请登录」)
flowchart TD
    A[打开首页 匿名访客] -->|服务器发 3847 纸条| B[浏览器存 Cookie]
    B -->|登录请求 + 3847| C[服务器验密码]
    C -->|翻本子 3847 页 改姓名为小明| D[已登录]
    D -->|带 3847 访问| E[商品页 显示用户名]
    D -->|带 3847 加入购物车| F[服务器本子记购物车]
    F -->|带 3847 结账| G[生成订单 清空购物车]
    G -->|点退出| H[撕掉 3847 页 扔掉纸条]
    H --> A
三个核心认知
- **Cookie 全程不变**:从打开首页到退出,浏览器口袋里的纸条都写着 3847 这同一个号码。变化的不是纸条,是服务器小本本上那一页的内容。
- **Session 是状态机**:小本本上 3847 这一页,随着用户行为不断被修改——匿名 → 登录 → 加购物车 → 结账 → 退出,整条状态都在这一页上演进。
- **购物车等临时数据在服务器**:很多人误以为购物车存在 Cookie 里,其实它存在服务器的小本本上。Cookie 只负责「报上名来」,真正的数据是服务器自己存。
**要点**:Cookie + Session 就像凭票根查表——浏览器每次出示编号纸条,服务器翻小本本上对应那一页,状态全在那一页里演进。
同一流程的 Token 版
上一块我们怎么走过来的?
上一块用的是「小纸条 + 小本本」方案:浏览器口袋里的纸条只写一个编号,服务器去小本本上翻那一页才知道你是谁、购物车里有什么。这套方案在淘宝这种「一家网站干完所有事」的场景下完全够用。
但场景一变呢?比如你在淘宝里点开一个第三方店铺的页面,或者用手机 App 登录——这些场景里,服务器可能「不认识你」,或者说没办法快速翻小本本。这时候就需要另一种思路:**Token(令牌)**。
Token 是什么?一张自带信息的身份证
Token 方案的比喻很简单:
- 上一块的 Cookie 是一张**只写编号的小纸条**,必须配合小本本才能查出你的身份
- Token 是一张**自带信息的身份证**,上面直接写明「持有人:小明;有效期:到今晚 12 点」,末尾还盖着服务器的钢印
服务器每次收到这张身份证,只需要**验证钢印是不是真的**(这一步叫「验签」),验证通过就直接读卡上的信息。**整个过程不用去翻任何小本本。**
这是两种思路最根本的区别:**Session 靠查表,Token 靠验签**。
用 Token 走一遍购物流程
小明用 Token 方式登录淘宝,流程会变成这样:
**第 1 步:登录**
- 服务器验证密码正确后,**生成一张身份证(Token)**:上面写着「user=小明;expires=今晚12点;role=普通用户」,末尾盖上只有服务器知道的密钥生成的签名
- 服务器把身份证塞进响应里返回给浏览器
**第 2 步:浏览器存证**
- 浏览器把身份证存进一个地方(可以是 localStorage、sessionStorage、内存里——不一定非要走 Cookie 那个「浏览器专属口袋」)
- 关键差别:这张身份证**不依赖任何服务器就能读懂上面的信息**(因为信息就印在卡上)
**第 3 步:访问商品页 / 加购物车 / 结账**
- 浏览器把身份证塞进请求的 Authorization 头里(不是 Cookie 字段,是另一条传送带)
- 服务器:拿身份证 → **验钢印** → 通过 → **读卡上的 user 字段** → 知道是小明
- 全程没有「翻小本本」这一步
**第 4 步:退出登录**
- 浏览器**自己把身份证扔掉**(从 localStorage 里删掉)
- 服务器**不需要做任何事**——它本来就没存任何东西
- 这是和 Session 方案最大的体感差异:退出登录几乎是「秒退」
flowchart LR
    subgraph Session[Session 方案 查小本本]
    S1[登录] --> S2[发小纸条 编号 3847]
    S2 --> S3[每次请求 服务器翻小本本]
    end
    subgraph Token[Token 方案 验钢印]
    T1[登录] --> T2[发身份证 盖钢印]
    T2 --> T3[每次请求 验钢印读卡]
    end
三个维度的关键差异
**1. 是否查小本本**
- Session:每次都要去小本本查「3847 这一页写了啥」
- Token:从来不查本子,只验钢印、读卡上的信息
- 后果:Token 方案的服务器**不需要为每个用户都存一份状态**,省存储,也方便横向扩展(多台服务器不用共享小本本)
**2. 凭证存放在哪**
- Session:编号纸条(Cookie)放浏览器;状态存服务器小本本
- Token:整张身份证(包含身份信息)放浏览器**或** App 内存里;服务器**几乎不存任何东西**
- 后果:Token 对客户端存储方式更灵活——可以放 localStorage、可以放内存、可以放手机 App 的钥匙串,不强求 Cookie 那种浏览器专用口袋
**3. 跨域表现**
- Session + Cookie:那张小纸条上印着「仅限 taobao.com 使用」——浏览器到了别的域名会拒绝带上它
- Token:身份证上不印域名,理论上你出示给谁看都行——只要对方**也认识这个钢印**(持有相同的验签密钥)
- 后果:Token 天然适合跨域场景——比如一家公司的主站 a.com 和子站 b.com 可以共用登录;手机 App 调服务端 API 也常用 Token
**一个常见的现实组合**:现在很多产品是「Cookie + Session 用来识别网页端用户」+「Token 用来给 App 或第三方 API 用」——两套方案并存,各管各的场景。
Token 的两个小代价
凡事有 trade-off,Token 也有两个明显的代价:
- **不能主动吊销**:服务器小本本可以随时撕掉某一页让某人下线;但身份证一旦发出去,服务器没法强制作废(除非维护一个「黑名单」——那其实就退化成查小本本了)。所以 Token 通常设较短有效期 + 配合「刷新令牌」机制
- **身份信息暴露在客户端**:身份证上的明文信息任何人都能读(钢印防的是「篡改」,不是「偷看」)。所以**敏感信息绝不能直接写进 Token**,只放用户 ID、角色、过期时间这种不敏感字段
**要点**:Token 是「自带信息的身份证」——服务器只验钢印不查小本本,凭证放在客户端,跨域灵活;代价是无法主动吊销、且不能把敏感信息写进 Token。
向外讲明白的一句话总结
整张图的一句话
前面两节我们走完了两套完整方案,但要真正「向外讲明白」,你得能一句话抓住整个故事的骨头:
**HTTP 失忆、凭证接力;Cookie 是传送带、Session 是小本本、Token 是自带信息的证件——三种思路解决同一个问题。**
这句话里藏了四个概念、三个比喻、一条主线。我们一个一个拆开。
「HTTP 失忆」——问题的起点
要理解「登录态怎么维持」,得先承认一个尴尬事实:**HTTP 协议天然不记事。**服务器每收到一个请求,都当作「第一次见面」处理。
- 你点商品页——服务器:你好你是谁?
- 你点加购物车——服务器:你好你是谁?(它忘了你刚点过商品页)
- 你点结账——服务器:你好你是谁?(它也忘了购物车里有啥)
这就是「HTTP 失忆」。登录态维持要解决的,**本质上就是帮这个失忆症患者在每次请求时重新认识你。**
「凭证接力」——所有方案的共同主线
既然服务器每请求都失忆,那唯一办法就是**让浏览器每次请求都主动带个「自我介绍」**——也就是凭证。三种方案的本质都是「凭证接力」,区别只在**凭证长什么样、放在哪、服务器怎么处理它**:
| 方案 | 凭证长啥样 | 凭证放哪 | 服务器怎么用 | |------|----------|---------|------------| | Cookie + Session | 只写编号的小纸条 | 浏览器口袋(自动传送) | 翻小本本查编号 | | Token | 自带信息的身份证 | 浏览器/App 内存或 localStorage | 验钢印 + 读卡 |
**关键洞察**:三种方案没有谁更「高级」,它们是**同一个问题的三种解法**,选哪个取决于场景:
- 一家网站干完所有事?Cookie + Session 够用
- 跨 App 调 API?Token 灵活
- 第三方登录、开放平台?Token 是标配
理解这一点,你就不会被网上「Token 取代 Session」的说法带偏——它们经常**并存**。
三个比喻的「骨灰级记忆法」
要让别人也记住,你只需要反复强化这套**视觉化比喻**:
- **Cookie = 传送带**:浏览器口袋里的一条自动传送带,每次请求**自动**把凭证捎上
- **Session = 小本本**:服务器桌上的一本记账本,编号是索引,存的是「这人是小明、购物车有啥」
- **Token = 自带信息的身份证**:不用查任何本子,卡上印着所有信息,末尾盖着钢印防伪
这三个比喻**来自生活、容易画面化、彼此区分明显**——任何人听完都画得出来、记得住。
一段能直接用的话术
假设你朋友问:「我登录淘宝之后,刷新页面为啥还是登录状态?它怎么记住我的?」
你可以这样回答:
> 「HTTP 协议是失忆的——服务器每次收到请求都当第一次见你。所以你登录之后,浏览器拿到一个**凭证**,之后每次请求都**自动带上**这个凭证给服务器看,服务器看到凭证就知道『哦,这是小明』。 > > 凭证有三种玩法:最传统的是**小纸条 + 小本本**——纸条只写编号,服务器翻本子查你是谁;升级版是**自带信息的身份证**——卡上写明所有信息,末尾盖钢印防伪,服务器验个钢印就行;现在很多 App 用的是身份证方案,因为它跨 App、跨域更灵活。 > > 不管哪种,**本质都是『HTTP 失忆、凭证接力』**——浏览器每次主动出示凭证,服务器每次重新确认你。」
这段话 1 分钟讲完,朋友听完能复述,你就真的「讲明白了」。
flowchart TD
    A[HTTP 失忆] --> B[需要凭证接力]
    B --> C[三种方案]
    C --> D1[Cookie 传送带]
    C --> D2[Session 小本本]
    C --> D3[Token 身份证]
    D1 --> E[每次请求自动捎编号]
    D2 --> F[服务器翻本子查身份]
    D3 --> G[服务器验钢印读卡]
    E --> H[解决同一个问题]
    F --> H
    G --> H
**要点**:整张图可以压缩成一句——**HTTP 失忆、凭证接力**;Cookie、Session、Token 是这个主线下三种不同形态的解法,没有优劣、只有场景适配。
学习笔记
完整登录流程与方案对比笔记
一、Cookie + Session 完整流程
六步走完全程
- **打开首页(未登录)**:浏览器发请求到服务器,服务器发现是新访客,在「小本本」上新建一页(如「匿名访客 #3847」),并通过 `Set-Cookie: session_id=3847` 让浏览器把编号纸条存进「淘宝」专属口袋,返回首页 HTML。
- **登录**:浏览器把用户名密码和纸条 3847 一起发出;服务器验证密码后,翻到 3847 这一页,把「姓名栏」从「匿名访客」改为「小明」,并记下登录时间。纸条编号不变,只是本子上那页的意义变了。
- **跳到商品页**:浏览器自动带 3847;服务器翻到 3847 页,看到「姓名=小明」,返回详情页并显示「你好,小明」。
- **加入购物车**:浏览器还是带 3847;服务器翻 3847 页,在「购物车栏」写下「商品A × 1,¥99」。
- **结账**:浏览器带 3847;服务器翻 3847 页确认是小明本人且购物车有商品,生成订单(订单属于更长期的「账本」),扣款,清空购物车栏。
- **退出登录**:浏览器带 3847;服务器翻到 3847 页,把姓名栏改回空或撕掉这页,同时让浏览器把 3847 纸条扔掉(设置过期)。
三个核心认知
- **Cookie 全程不变**:从打开首页到退出,浏览器口袋里的纸条写的都是同一个编号。
- **登录不换纸条**:登录动作只是让服务器把本子上那页的姓名栏改字,编号纸条本身不变。
- **购物车数据存服务器**:购物车里的商品存在服务器小本本的 3847 页上,Cookie 那张纸条从头到尾只写了一个编号,真正的商品数据是服务器自己保管的。
二、Token 方案的完整流程
Token 是什么
- Cookie 方案是「只写编号的小纸条」,必须配合小本本才能查出身份。
- Token 是一张**自带信息的身份证**,上面直接写明「持有人、有效期、角色」等,末尾盖着只有服务器知道的密钥生成的签名(钢印)。
- 服务器收到后只需验签(验证钢印是否真),验证通过直接读卡上信息,**不用翻任何小本本**。
- 两种思路最根本的区别:**Session 靠查表,Token 靠验签**。
用 Token 走一遍购物流程
- **登录**:服务器验证密码后生成 Token(写明用户、过期时间、角色等并附签名),塞进响应返回。
- **浏览器存证**:把身份证存进 localStorage、sessionStorage 或内存(不一定走 Cookie 那条「专属口袋」),关键差别是这张身份证不依赖任何服务器就能读懂上面信息。
- **后续访问**:浏览器把身份证塞进请求的 Authorization 头(不是 Cookie 字段,是另一条传送带),服务器验钢印通过后直接读卡上 user 字段,知道是小明。
- **退出登录**:浏览器自己从 localStorage 删掉身份证,服务器不需要做任何事——它本来就没存任何东西,体感是「秒退」。
Session 与 Token 三个维度的关键差异
- **是否查小本本**
- Session:每次都要去小本本查编号对应页的内容。
- Token:从不查本子,只验钢印、读卡上信息。
- 后果:Token 方案服务器不需要为每个用户存一份状态,省存储,也方便横向扩展(多台服务器不用共享小本本)。
- **凭证存放在哪**
- Session:编号纸条(Cookie)放浏览器;状态存服务器小本本。
- Token:整张身份证放浏览器或 App 内存;服务器几乎不存东西。
- 后果:Token 对客户端存储方式更灵活。
- **退出登录的方式**
- Session:服务器删除本子上的页 + 让浏览器扔掉纸条(双方配合)。
- Token:浏览器自己删掉身份证,服务器无需动作。
三、整张图的一句话总结
HTTP 失忆、凭证接力
> **HTTP 失忆、凭证接力;Cookie 是传送带、Session 是小本本、Token 是自带信息的证件——三种思路解决同一个问题。**
问题的起点:HTTP 失忆
HTTP 协议天然不记事,服务器每收到一个请求都当「第一次见面」处理。登录态维持本质上就是帮这个失忆症患者在每次请求时重新认识你。
共同主线:凭证接力
既然服务器每请求都失忆,唯一办法就是让浏览器每次请求都主动带「自我介绍」——即凭证。三种方案的本质都是「凭证接力」,区别只在凭证长什么样、放在哪、服务器怎么处理。
| 方案 | 凭证长啥样 | 凭证放哪 | 服务器怎么用 | |------|----------|---------|------------| | Cookie + Session | 只写编号的小纸条 | 浏览器口袋(自动传送) | 翻小本本查编号 | | Token | 自带信息的身份证 | 浏览器/App 内存或 localStorage | 验钢印 + 读卡 |
三个比喻的骨灰级记忆法
- **Cookie = 传送带**:浏览器口袋里的一条自动传送带,每次请求自动把凭证捎上。
- **Session = 小本本**:服务器桌上的记账本,编号是索引,存的是「这人是小明、购物车有啥」。
- **Token = 自带信息的身份证**:不用查任何本子,卡上印着所有信息,末尾盖着钢印防伪。
方案选择
三种方案没有谁更「高级」,是同一个问题的三种解法:
- 一家网站干完所有事 → Cookie + Session 够用。
- 跨 App 调 API → Token 灵活。
- 第三方登录、开放平台 → Token 是标配。
它们经常并存,不存在「Token 取代 Session」的绝对说法。